Die Kurzfassung. Wenn sich die Stimme deiner KI-Moderatorin von Clip zu Clip verändert, liegt das Problem wahrscheinlich nicht an der Text-to-Speech-Funktion — sondern am Videomodell. Seedance 2.5 singt dein Voiceover bei jedem Take neu ein und wählt die Raumakustik anhand der Einstellungsgröße aus. Normalisiere die Lautstärke auf einen Zielwert, halte jeden Sprechabschnitt auf derselben Einstellungsdistanz, und wenn die exakte Sprachdatei erhalten bleiben muss, generiere mit Wan 3.0, das unser Audio unverändert durchgereicht hat.
Wir haben fünf Dinge in vier Szenen eines Tutorials mit einer generierten Moderatorin gemessen, und Text-to-Speech erwies sich als unschuldig.
Eine Frau, ein Raum, eine Stimme, zwölf Minuten Material. Jeder Clip sah für sich genommen gut aus. Schneidet man sie zusammen, fiel sie auseinander: hell und nah in der einen Einstellung, dumpf und fern in der nächsten, als wäre sie mitten im Satz zwischen einer Podcast-Kabine und der Küche von irgendjemandem hin- und hergewandert.
Warum klingt eine KI-Moderatorin in jedem Clip anders?
Hör auf, zuerst zu raten. Takes immer wieder neu zu generieren, bis sie richtig klingen, ist teuer und sagt dir gar nichts. Deshalb haben wir dieselben fünf Dinge an der Text-to-Speech-Quelle und am fertigen Audio über vier Szenen hinweg gemessen: Tonhöhe, spektrale Helligkeit, integrierte Lautheit, Grundrauschen und Sprachpegel. Eine einzige Tabelle erzählte die ganze Geschichte.
| Schwankung von Szene zu Szene | Text-to-Speech-Quelle | Audio des fertigen Clips |
|---|---|---|
| Lautstärke | 0.5 LU | 9.4 LU |
| Sprechpegel | 2.5 dB | 8.3 dB |
| Tonhöhe (mediane F0) | 17.3 Hz | 9.5 Hz |
| Raumton (Grundrauschen) | 10.6 dB | 4.8 dB |
Spanne = lauteste bis leiseste Szene, höchste bis niedrigste Tonhöhe.
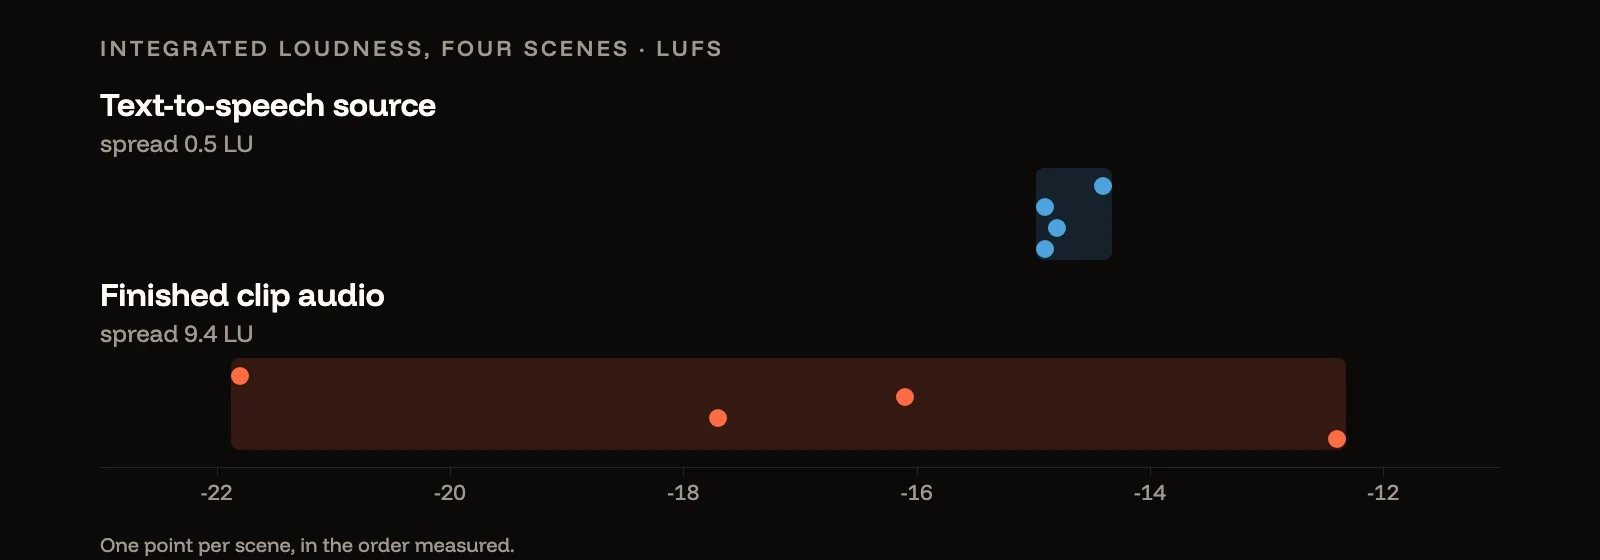
Das Text-to-Speech war nahezu perfekt: vier Szenen mit −14,4, −14,9, −14,8 und −14,9 LUFS. Das Videomodell lieferte −21,8, −16,1, −17,7 und −12,4 zurück. Die Schwankung von neuneinhalb Dezibel ist das, was hinter „sie klingt bei jedem Schnitt anders“ tatsächlich steckt.
Beachte die zwei Zeilen, die genau andersherum verlaufen. Tonhöhe und Raumton waren nach dem Videomodell konsistenter als davor. Das, wovon wir annahmen, dass es driften würde, driftete überhaupt nicht.
Nutzt das Videomodell dein Voiceover oder generiert es neu?
Einige Modelle verwenden es. Einige singen es noch einmal neu ein. Das war die Erkenntnis, die unsere Pipeline verändert hat. Wir haben das Quellaudio mit dem im jeweiligen fertigen Clip eingebetteten Audio kreuzkorreliert und anschließend überprüft, ob die Ausrichtung hielt.
| Modell | Korrelation mit der Quelle | Drift über den Clip |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 gibt deine Wellenform um eine feste Verzögerung verschoben zurück. Seedance 2.5 gibt eine neue Performance zurück: konditioniert auf deine Referenz, erkennbar derselbe Charakter, aber neu synthetisiert. Gemessen an der Quelle senkte es die Tonhöhe um 0.2 bis 1.3 Halbtöne und dunkelte die Klangfarbe um 5 bis 19 Prozent ab, bei jedem Take anders.
Für ein Modell, das neu einsingt, folgen zwei Konsequenzen, und beide sind von Bedeutung.
Kein Prompt wird das beheben. Die Abweichung entsteht innerhalb der Audiosynthese des Modells, nicht durch etwas, das du beschreiben kannst. Wir haben viel Zeit damit verbracht, sorgfältige Anweisungen für einen konsistenten Raumton zu schreiben, bevor wir gemerkt haben, dass der Raumton bereits konsistent war.
Du kannst das saubere Audio nicht einfach wieder einfügen. Es sieht nach der perfekten Lösung aus — behalte das gute Bild, lege deine makellose Tonspur darunter — doch bei Seedance schlägt das fehl, weil die Lippen der neu getimten Performance des Modells folgen, die am Ende des Clips um bis zu 440 ms von deiner Datei abgewichen ist.
Welches Modell solltest du für eine sprechende Moderatorin nutzen?
Entscheide, was die Generierung überstehen muss.
- Die exakte Sprachdatei muss erhalten bleiben — eine geklonte Markenstimme, ein Skript, das Wort für Wort sitzen muss, ein Voiceover, das ein Kunde bereits freigegeben hat. Nutze Wan 3.0. Dessen Ausgabe bleibt an deine Datei mit einem festen Versatz gebunden, sodass du die Verzögerung entfernen und die Originaltonspur wieder unter das Bild legen kannst. Audio-Referenzen sind pro Anfrage auf insgesamt 15 Sekunden begrenzt, plane Sprechabschnitte also in Abschnitten dieser Länge.
- Die Performance darf sich verändern — die eigene Interpretation des Modells ist akzeptabel und dir ist die Einstellung wichtiger als die exakte Wellenform. Seedance 2.5 ist dafür gut geeignet, und der Rest dieses Beitrags erklärt, wie du dafür sorgst, dass seine Takes zueinander passen.
So oder so beginnt die Stimme selbst im Text-to-Speech-Generator; eine konsistente Quelle ist der eine Teil, der nie das Problem war.
Warum klingt eine KI-Moderatorin in Totalen weit entfernt?
Das Modell passt den Raum an die Einstellung an. Das Gefühl von Podcast-Kabine im Vergleich zu Küche stammt vom Raum. Deshalb haben wir das Direkt-zu-Nachhall-Verhältnis gemessen — wie trocken und nah eine Stimme klingt im Vergleich dazu, wie viel Raum sie umgibt — sowie die Nachhallzeit nach jeder Phrase.
| Szene | Einstellungsgröße | Trockenheit | Nachhallzeit |
|---|---|---|---|
| Geständnis-Moment | Nah | 2.8 | 116 ms |
| Einleitung | Nah | 3.1 | 81 ms |
| Eröffnung | Total | 1.3 | 139 ms |
| Abschluss | Total | 0.3 | 209 ms |
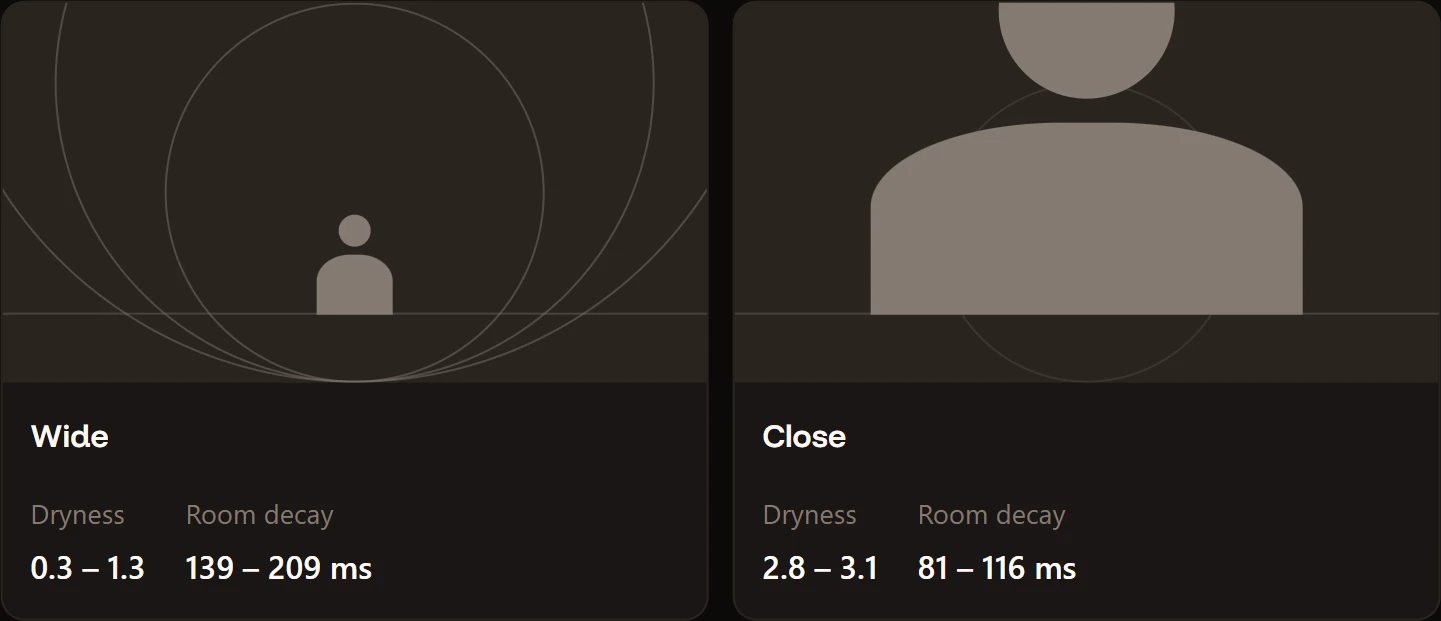
Die Weitwinkel-Einstellungen klingen hallig; die beiden Nahaufnahmen sind trocken und intim. Das Modell leitet die Akustik aus der Einstellungsgröße ab — eine Person, die von der anderen Seite eines Raumes gefilmt wird, sollte weiter entfernt klingen, also platziert das Modell sie weiter entfernt. Das ist ein gutes filmisches Gespür. Es ist jedoch solange unsichtbar, bis man eine weite Einstellung gegen eine nahe schneidet und die Moderatorin zu teleportieren scheint.
Kann man inkonsistentes KI-Video-Audio in der Postproduktion korrigieren?
Zwei Drittel davon. Wir haben eine Matching-Kette aufgebaut und sie ehrlich gemessen.
| Vorher | Nachher | |
|---|---|---|
| Lautstärkespreizung | 9.4 LU | 0.4 LU |
| Klangfarbenspreizung | 2.9 dB | 1.1 dB |
| Raumtonspreizung | 2.3 dB | unverändert |
Eine Zwei-Pass-Lautstärkenormalisierung auf einen einzigen Zielwert beseitigt das Lautstärkeproblem vollständig. Es kostet nichts und du solltest es auf jeden Fall tun. Miss jeden Clip und korrigiere ihn dann mit den Werten, die die Messung ergeben hat, wobei ein Zielwert für jeden Clip im Schnitt verwendet wird:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
Ein sanfter Shelf-EQ pro Clip gleicht die Klangfarbe weitgehend an.
Der Nachhall ist das Einzige, was sich nicht beugt. Wir haben jedem Clip einen kleinen gemeinsamen Raum hinzugefügt, damit sie sich eine Nachhallfahne teilen, und das machte die Streuung schlimmer, von 2,3 dB auf 2,9 dB: Ein gemeinsamer Nachhall addiert sich zur bestehenden Nachhallfahne jedes Clips, anstatt sie zu ersetzen. Das Anpassen des Nachhalls funktioniert nur nach unten, indem man ihn entfernt, und das erfordert ein dediziertes Dereverb-Tool statt einer Filterkette.
Die ehrliche Antwort auf die Frage „Kann ich das in der Postproduktion beheben?“ lautet also: Zwei Drittel davon ja, und zwar kostenlos. Das letzte Drittel ist günstiger zu vermeiden als zu reparieren.
Wie hältst du die Stimme einer KI-Moderatorin über mehrere Clips hinweg konsistent?
Disziplin bei der Bildgestaltung, nicht beim Audio. Halte jeden sprechenden Moment in derselben Aufnahmeentfernung, und der Raumcharakter hört auf, sich zu verändern, weil das Modell nicht mehr aufgefordert wird, ihn zu ändern.
Wir kamen aus einer anderen Richtung zum selben Schluss. Als wir jeden Clip durch ein Videoverständnismodell als Qualitätsfilter schickten, erzielten die Nahaufnahmen 7 von 10 Punkten für Lippensynchronität ohne Versatz; die Totalen erzielten 4 bis 6 Punkte mit 40 bis 100 ms Versatz. Seine Erklärung: Bei einer Totale ist das Gesicht klein, sodass die Mundformen als Matsch wahrgenommen werden.
Zwei unabhängige Messungen, eine Antwort: Filme deine generierte Moderatorin nah und behalte sie dort. Nutze Totalen für Bewegung, für den Raum, für alles, wo sie nicht spricht. Wenn du die Akustik noch stabiler brauchst, beschreibe sie, anstatt sie erschließen zu lassen. Jeder Prompt verlangt nun nach einer Stimme, die nah und trocken am Mikrofon ist, wie bei einem Ansteckmikrofon eine Handbreit entfernt, ohne Raumecho.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
Wie überprüft man KI-Lippensynchronität automatisch?
Lass es von einem Modell für dich bewerten. Moderne Videoverständnis-Modelle — jedes aktuelle multimodale Modell, das Video akzeptiert — schauen sich einen Clip an und bewerten die Lippensynchronität, was eine subjektive Diskussion in eine Checkliste verwandelt. Unseres erfasste einen bilabialen Konsonanten, der sich nie ganz schloss, eine Spiegelreflexion im Hintergrund, die sich nicht mit dem Vordergrund animierte, und ein ungefordertes Zwinkern, das das Modell von sich aus hinzugefügt hatte. Es schätzte auch den Audio-Offset in Millisekunden, was genau die Zahl ist, die du brauchst, um zwischen zwei Wegen zu wählen. Wie Lippen-Sync-Modelle überhaupt funktionieren, erfährst du unter KI-Lippensynchronisationstechnologie erklärt.
Ein Vorbehalt: Die Modellwahl ist wichtiger als man erwarten würde. Ein älteres Modell bewertete jeden Clip identisch mit 6 von 10 und weigerte sich, irgendeinen Offset zu schätzen — unbrauchbar für ein Ranking. Ein neueres trennte sie sauber voneinander und lieferte die Offsets. Wenn dein Prüfkriterium sagt, dass alles gleich ist, zweifle am Prüfkriterium.
Wenn der Qualitätsfilter ein schlechtes Detail in einem ansonsten guten Take markiert, bearbeite den Clip, anstatt ihn neu zu generieren.
Die Kurzfassung
- Miss nach, bevor du neu generierst. Die Spanne über verschiedene Szenen hinweg zeigt in einer Tabelle, in welcher Phase der Fehler liegt.
- Deine Text-to-Speech-Funktion ist wahrscheinlich unschuldig.
- Einige Videomodelle reichen dein Audio durch; andere singen es neu ein. Seedance 2.5 singt neu ein; Wan 3.0 hat unseres durchgereicht. Das entscheidet darüber, ob du die saubere Tonspur jemals wieder einfügen kannst.
- Lautstärkenormalisierung ist kostenlos und behebt das größte Problem.
- Nachhall lässt sich nicht durch das Hinzufügen von noch mehr Nachhall beheben. Wir haben es ausprobiert.
- Halte die Kamera bei Sprechabschnitten nah und halte die Distanz konstant. Das korrigiert die Akustik und die Lippensynchronität auf einmal.
Jede Zahl auf dieser Seite wurde an unseren eigenen Takes gemessen, die mit Popcraft generiert wurden. Das Titelbild stellt die Lautstärkewerte aus der ersten Tabelle dar. Methode: Tonhöhe über pYIN bei stimmhaften Frames, Lautstärke über das EBU-R128-Messgerät, Trockenheit als Verhältnis der ersten 50 ms jedes Sprachbeginns zu den folgenden 150 ms, Ausklingzeit als die Zeit, die verstreicht, bis der Pegel nach dem Ende der Sprache um 20 dB abfällt.