La versión corta. Si la voz de tu presentadora de IA cambia de un clip a otro, lo más probable es que el problema no sea la conversión de texto a voz, sino el modelo de vídeo. Seedance 2.5 vuelve a cantar tu voz en off en cada toma y elige la acústica de la sala según el tamaño del plano. Normaliza el volumen a un único objetivo, mantén cada intervención hablada a la misma distancia de plano y, cuando el archivo de voz exacto tenga que mantenerse intacto, genera con Wan 3.0, que dejó nuestro audio intacto.
Medimos cinco cosas en cuatro escenas de un tutorial con una presentadora generada, y el texto a voz resultó ser inocente.
Una mujer, una habitación, una voz, doce minutos de material. Cada clip se veía bien por sí solo. Al montarlos juntos, todo se desmoronaba: brillante y cercana en una toma, apagada y distante en la siguiente, como si a mitad de frase hubiera vagado entre una cabina de pódcast y la cocina de alguien.
¿Por qué una presentadora de IA suena diferente en cada clip?
Primero, deja de adivinar. Volver a generar tomas hasta que suenen bien es caro y no te aporta ninguna información. Así que medimos las mismas cinco cosas en la fuente de conversión de texto a voz y en el audio final, a lo largo de cuatro escenas: tono, brillo espectral, sonoridad integrada, ruido de fondo y nivel de voz. Una sola tabla contó toda la historia.
| Dispersión entre escenas | Fuente de texto a voz | Audio del clip final |
|---|---|---|
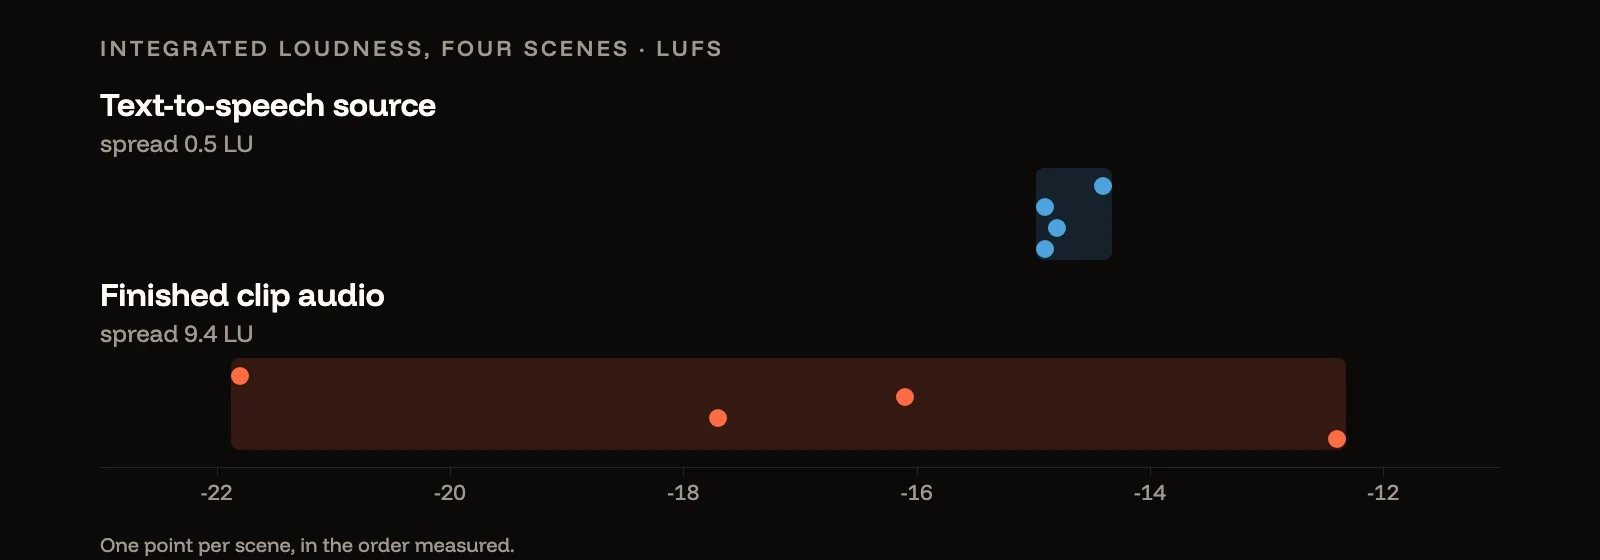
| Sonoridad | 0.5 LU | 9.4 LU |
| Nivel de voz | 2.5 dB | 8.3 dB |
| Tono (F0 mediana) | 17.3 Hz | 9.5 Hz |
| Tono de sala (ruido de fondo) | 10.6 dB | 4.8 dB |
Dispersión = de la escena con más volumen a la más silenciosa, del tono más alto al más bajo.
El texto a voz era casi perfecto: cuatro escenas a −14,4, −14,9, −14,8 y −14,9 LUFS. El modelo de vídeo devolvió −21,8, −16,1, −17,7 y −12,4. Esa variación de nueve decibelios y medio es lo que realmente significa «suena diferente en cada corte».
Fíjate en las dos filas que van en sentido contrario. El tono y el tono de la sala eran más consistentes después del modelo de vídeo que antes de este. Lo que dábamos por hecho que variaba no variaba en absoluto.
¿El modelo de vídeo usa tu voz en off o la regenera?
Algunos modelos lo usan. Otros vuelven a cantarlo. Este fue el hallazgo que cambió nuestro proceso de trabajo. Realizamos una correlación cruzada entre el audio de origen y el audio integrado en cada clip final, y luego comprobamos si la alineación se mantenía.
| Modelo | Correlación con la fuente | Desviación a lo largo del clip |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 te devuelve la forma de onda, desplazada por un retardo fijo. Seedance 2.5 te devuelve una nueva interpretación: condicionada por tu referencia, reconociblemente el mismo personaje, pero resintetizada. Comparada con la fuente, bajó el tono de 0.2 a 1.3 semitonos y oscureció el timbre entre un 5 y un 19 por ciento, de forma distinta en cada toma.
En el caso de un modelo que vuelve a cantar, se derivan dos consecuencias, y ambas son importantes.
Ningún prompt lo solucionará. La variación se produce dentro de la síntesis de audio del modelo, no en algo que puedas describir. Pasamos tiempo escribiendo instrucciones detalladas sobre un tono de sala constante antes de darnos cuenta de que el tono de sala ya era constante.
No puedes volver a sustituir el audio limpio. Parece la solución perfecta (conservar la buena imagen y colocar la pista de voz impecable debajo), pero en Seedance falla, porque los labios siguen la interpretación reajustada del propio modelo, que se ha desfasado hasta 440 ms de tu archivo al final del clip.
¿Qué modelo deberías usar para una presentadora hablante?
Decide qué tiene que sobrevivir a la generación.
- El archivo de voz exacto tiene que sobrevivir: una voz de marca clonada, un guion que debe encajar palabra por palabra, una voz en off que un cliente ya ha aprobado. Usa Wan 3.0. Su resultado se mantiene sincronizado con tu archivo a un desfase fijo, de modo que puedes eliminar el retraso y volver a colocar la pista original debajo de la imagen. Las referencias de audio están limitadas a un máximo de 15 segundos en total por solicitud, así que planifica los fragmentos hablados en piezas de esa duración.
- La interpretación puede variar: la propia lectura del modelo es aceptable y te importa más el plano que la forma de onda exacta. Seedance 2.5 está bien, y el resto de esta publicación explica cómo hacer que sus tomas coincidan.
En cualquier caso, la voz en sí comienza en el generador de texto a voz; una fuente consistente es la única parte que nunca fue el problema.
¿Por qué una presentadora de IA suena lejana en los planos generales?
El modelo adapta la sala a la toma. La sensación de «cabina de pódcast frente a cocina» proviene de la sala, así que medimos la relación entre sonido directo y reverberante (lo seca y cercana que suena una voz frente a cuánta sala hay a su alrededor) y el tiempo de decaimiento después de cada frase.
| Escena | Encuadre | Sequedad | Decaimiento de sala |
|---|---|---|---|
| Momento de confesión | Primer plano | 2.8 | 116 ms |
| Introducción | Primer plano | 3.1 | 81 ms |
| Apertura | Plano general | 1.3 | 139 ms |
| Cierre | Plano general | 0.3 | 209 ms |
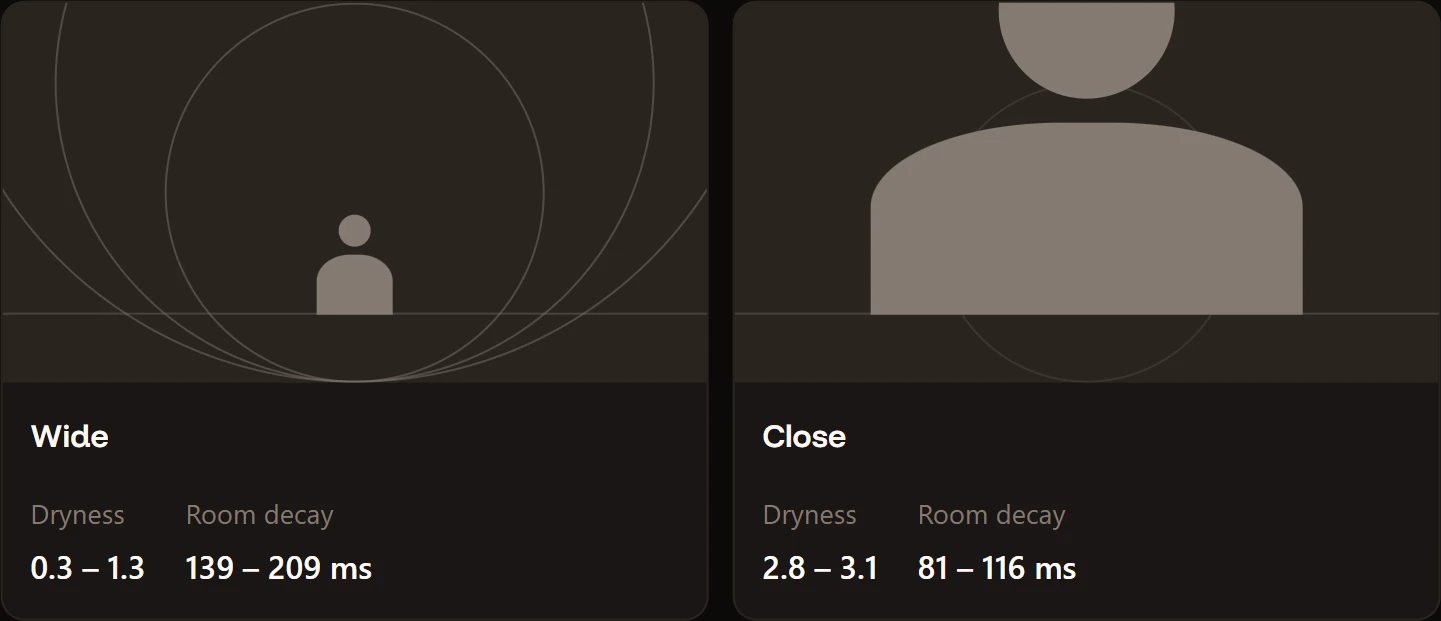
Las tomas abiertas son las que tienen más sala; ambas tomas cerradas son secas e íntimas. El modelo deduce la acústica a partir del encuadre: una persona filmada desde el otro lado de una habitación debería sonar más lejana, así que la sitúa más lejos. Es un buen instinto cinematográfico. También resulta invisible hasta que pones en el montaje un plano abierto junto a uno cerrado y tu presentadora parece teletransportarse.
¿Se puede corregir el audio inconsistente de un vídeo de IA en posproducción?
Dos tercios del problema. Construimos una cadena de ajuste y la medimos con honestidad.
| Antes | Después | |
|---|---|---|
| Dispersión de sonoridad | 9.4 LU | 0.4 LU |
| Dispersión de timbre | 2.9 dB | 1.1 dB |
| Dispersión de sala | 2.3 dB | sin cambios |
La normalización de sonoridad en dos pasadas con un solo objetivo elimina el problema de sonoridad por completo. No cuesta nada y deberías hacerlo de todos modos. Mide cada clip y luego corrígelo con los valores obtenidos de esa medición, utilizando el mismo objetivo para cada clip del montaje:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
Una suave ecualización tipo shelf por clip ajusta casi por completo el timbre.
La reverberación es el único aspecto que no cede. Añadimos una pequeña sala compartida a cada clip para que compartieran la misma cola, y eso hizo que la dispersión fuera peor, pasando de 2,3 dB a 2,9 dB: una reverberación compartida se suma a la cola existente de cada clip en lugar de reemplazarla. Igualar la reverberación solo funciona reduciéndola, quitándola, y para eso se necesita una herramienta dedicada a la desreverberación en lugar de una cadena de filtros.
Así pues, la respuesta sincera a «¿puedo arreglarlo en posproducción?» es: dos tercios, sí, y gratis. El tercio restante es más barato de evitar que de reparar.
¿Cómo mantener constante la voz de una presentadora de IA entre clips?
Disciplina de encuadre, no de audio. Mantén cada intervención hablada a la misma distancia de toma y el carácter de la sala dejará de cambiar, porque ya no se le pedirá al modelo que lo cambie.
Llegamos a la misma conclusión desde otro ángulo. Al pasar cada clip por un modelo de comprensión de vídeo como control de calidad, los primeros planos obtuvieron una puntuación de 7 sobre 10 en sincronización labial con cero desfase; los planos generales puntuaron de 4 a 6 con entre 40 y 100 ms de desfase. Su explicación: en un encuadre general la cara es pequeña, por lo que las formas de la boca se perciben borrosas.
Dos mediciones independientes, una sola respuesta: graba a tu presentadora generada en plano corto y mantenla ahí. Usa planos generales para el movimiento, para la sala o para cualquier momento en el que no esté hablando. Si necesitas que la acústica sea aún más estable, descríbela en lugar de dejar que se infiera. Ahora todos los prompt piden una voz cercana y seca al micrófono, como si llevara un micro de solapa a un palmo de distancia, sin eco de sala.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
¿Cómo comprobar la sincronización labial de la IA automáticamente?
Deja que un modelo lo evalúe por ti. Los modelos modernos de comprensión de vídeo (cualquier modelo multimodal actual que acepte vídeo) analizarán un clip y evaluarán la sincronización labial, lo que convierte un debate subjetivo en una lista de comprobación. El nuestro detectó una consonante bilabial que no llegaba a cerrarse del todo, un reflejo en un espejo de fondo que no se animaba en consonancia con el primer plano y un guiño no solicitado que el modelo había añadido por su cuenta. También calculó el desfase de audio en milisegundos, que es exactamente la cifra que necesitas para elegir entre dos vías. Para saber cómo funcionan los modelos de sincronización labial en primer lugar, consulta explicación de la tecnología de sincronización labial por IA.
Una advertencia: la elección del modelo importa más de lo que cabría esperar. Un modelo más antiguo puntuó cada clip exactamente igual, con un 6 de 10, y se negó a calcular ningún desfase: inútil para clasificar. Uno más reciente los diferenció claramente y proporcionó los desfases. Si tu filtro de control dice que todo es igual, desconfía del filtro.
Cuando el control de calidad detecte un mal detalle en una toma que por lo demás es buena, edita el clip en lugar de volver a generarlo.
La versión corta
- Mide antes de volver a generar. La dispersión entre escenas identifica en una sola tabla la fase que falla.
- Es probable que la conversión de texto a voz no sea la culpable.
- Algunos modelos de vídeo transmiten tu audio tal cual; otros lo vuelven a cantar. Seedance 2.5 lo vuelve a cantar; Wan 3.0 transmitió el nuestro. Eso determina si alguna vez podrás volver a incluir la pista limpia.
- La normalización del volumen es gratuita y soluciona el mayor problema.
- La reverberación no se corrige añadiendo más reverberación. Lo hemos comprobado.
- Graba los fragmentos hablados de cerca y mantén la distancia constante. Corrige la acústica y la sincronización labial al mismo tiempo.
Todos los números de esta página se midieron en nuestras propias tomas, generadas con Popcraft. La portada representa las cifras de volumen de la primera tabla. Método: tono mediante pYIN en fotogramas con voz, volumen mediante el medidor EBU R128, sequedad como la proporción de los primeros 50 ms de cada inicio de voz respecto a los 150 ms siguientes, decaimiento como el tiempo necesario para bajar 20 dB tras detenerse el habla.