En résumé. Si la voix de votre présentatrice IA change d'un clip à l'autre, le problème ne vient probablement pas de la synthèse vocale, mais du modèle vidéo. Seedance 2.5 rechante votre voix off à chaque prise et choisit l'acoustique de la pièce en fonction de la valeur de plan. Normalisez le volume sur une cible unique, conservez chaque séquence parlée à la même distance de prise de vue, et lorsque le fichier audio exact doit être préservé, générez sur Wan 3.0, qui a conservé notre audio intact.
Nous avons mesuré cinq éléments sur quatre scènes d'un tutoriel avec une présentatrice générée, et la synthèse vocale s'est avérée innocente.
Une femme, une pièce, une voix, douze minutes de matériel. Chaque clip rendait bien isolément. Montez-les ensemble et tout s'effondrait : claire et proche dans un plan, étouffée et distante dans le suivant, comme si elle s'était promenée entre une cabine de podcast et la cuisine de quelqu'un au milieu d'une phrase.
Pourquoi une présentatrice IA a-t-elle une voix différente dans chaque clip ?
Arrêtez de deviner d'abord. Régénérer des prises jusqu'à ce qu'elles semblent correctes coûte cher et ne vous apprend rien. Nous avons donc mesuré les cinq mêmes paramètres sur la source de synthèse vocale et sur l'audio final, à travers quatre scènes : la hauteur tonale, la brillance spectrale, l'intensité sonore intégrée, le bruit de fond et le niveau de parole. Un seul tableau a résumé toute l'histoire.
| Écart d'une scène à l'autre | Source de synthèse vocale | Audio du clip final |
|---|---|---|
| Volume sonore | 0,5 LU | 9,4 LU |
| Niveau de parole | 2,5 dB | 8,3 dB |
| Hauteur de la voix (F0 médiane) | 17,3 Hz | 9,5 Hz |
| Bruit ambiant (bruit de fond) | 10,6 dB | 4,8 dB |
Écart = de la scène la plus forte à la plus silencieuse, du ton le plus aigu au plus grave.
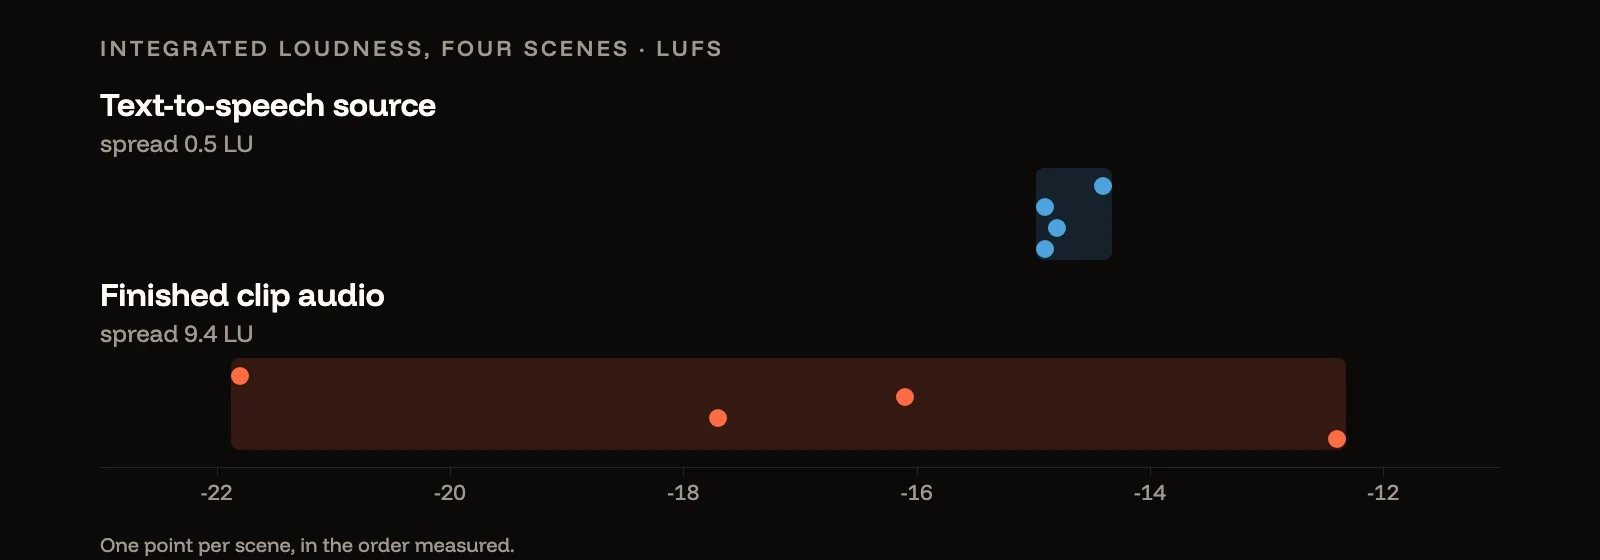
La synthèse vocale était presque parfaite : quatre scènes à −14,4, −14,9, −14,8 et −14,9 LUFS. Le modèle vidéo a renvoyé −21,8, −16,1, −17,7 et −12,4. Cet écart de neuf décibels et demi est exactement ce que signifie en réalité « elle a une voix différente à chaque plan ».
Notez les deux lignes qui vont dans le sens inverse. La hauteur tonale et le bruit ambiant étaient plus constants après le modèle vidéo qu'avant lui. Ce que nous pensions dériver ne dérivait pas du tout.
Le modèle vidéo utilise-t-il votre voix off, ou la régénère-t-il ?
Certains modèles l'utilisent. D'autres la rechantent. C'est la découverte qui a changé notre pipeline. Nous avons effectué une corrélation croisée entre l'audio source et l'audio intégré dans chaque clip terminé, puis nous avons vérifié si l'alignement se maintenait.
| Modèle | Corrélation avec la source | Dérive sur l'ensemble du clip |
|---|---|---|
| Seedance 2.5 | 0,30 – 0,55 | 120 – 440 ms |
| Wan 3.0 | 0,82 – 0,95 | 0 ms |
Wan 3.0 vous restitue votre forme d'onde, décalée d'un retard fixe. Seedance 2.5 restitue une nouvelle interprétation : conditionnée par votre référence, le personnage est reconnaissable, mais resynthétisé. Par rapport à la source, il a abaissé la hauteur de la voix de 0,2 à 1,3 demi-tons et assombri le timbre de 5 à 19 %, différemment à chaque prise.
Pour un modèle qui rechante, deux conséquences en découlent, et toutes deux comptent.
Aucun prompt ne résoudra le problème. La variation se produit au sein de la synthèse audio du modèle, et non dans ce que vous pouvez décrire. Nous avons passé du temps à rédiger des instructions précises pour obtenir une ambiance sonore cohérente avant de réaliser que l'ambiance sonore était déjà cohérente.
Vous ne pouvez pas réinsérer l'audio propre. Cela semble être la solution idéale — garder la bonne image, placer votre piste vocale originale en dessous —, mais sur Seedance, cela échoue, car les lèvres suivent la prestation réalignée par le modèle lui-même, qui a dérivé jusqu'à 440 ms par rapport à votre fichier à la fin du clip.
Quel modèle devez-vous utiliser pour une présentatrice qui parle ?
Déterminez ce qui doit être conservé lors de la génération.
- Le fichier vocal exact doit être préservé — une voix de marque clonée, un texte qui doit être prononcé mot pour mot, une voix off déjà approuvée par un client. Utilisez Wan 3.0. Sa sortie reste calée sur votre fichier avec un décalage fixe, ce qui vous permet de supprimer le retard et de replacer la piste originale sous l'image. Les références audio sont limitées à 15 secondes au total par requête, planifiez donc les séquences parlées par tranches de cette durée.
- L'interprétation peut varier — la lecture propre au modèle est acceptable, et le plan vous importe plus que la forme d'onde exacte. Seedance 2.5 convient parfaitement, et la suite de cet article vous explique comment harmoniser ses prises.
Quoi qu'il en soit, la voix elle-même commence dans le générateur de synthèse vocale ; une source constante est la seule partie qui n'a jamais posé problème.
Pourquoi une présentatrice IA semble-t-elle distante dans les plans larges ?
Le modèle adapte la pièce au plan. Le sentiment de passer d'une cabine de podcast à une cuisine provient de la pièce ; nous avons donc mesuré le rapport champ direct/champ réverbéré — le côté sec et proche de la voix par rapport à l'espace environnant — ainsi que le temps de décroissance après chaque phrase.
| Scène | Cadrage | Sécheresse | Réverbération de la pièce |
|---|---|---|---|
| Moment de confidence | Gros plan | 2,8 | 116 ms |
| Introduction | Gros plan | 3,1 | 81 ms |
| Ouverture | Plan large | 1,3 | 139 ms |
| Clôture | Plan large | 0,3 | 209 ms |
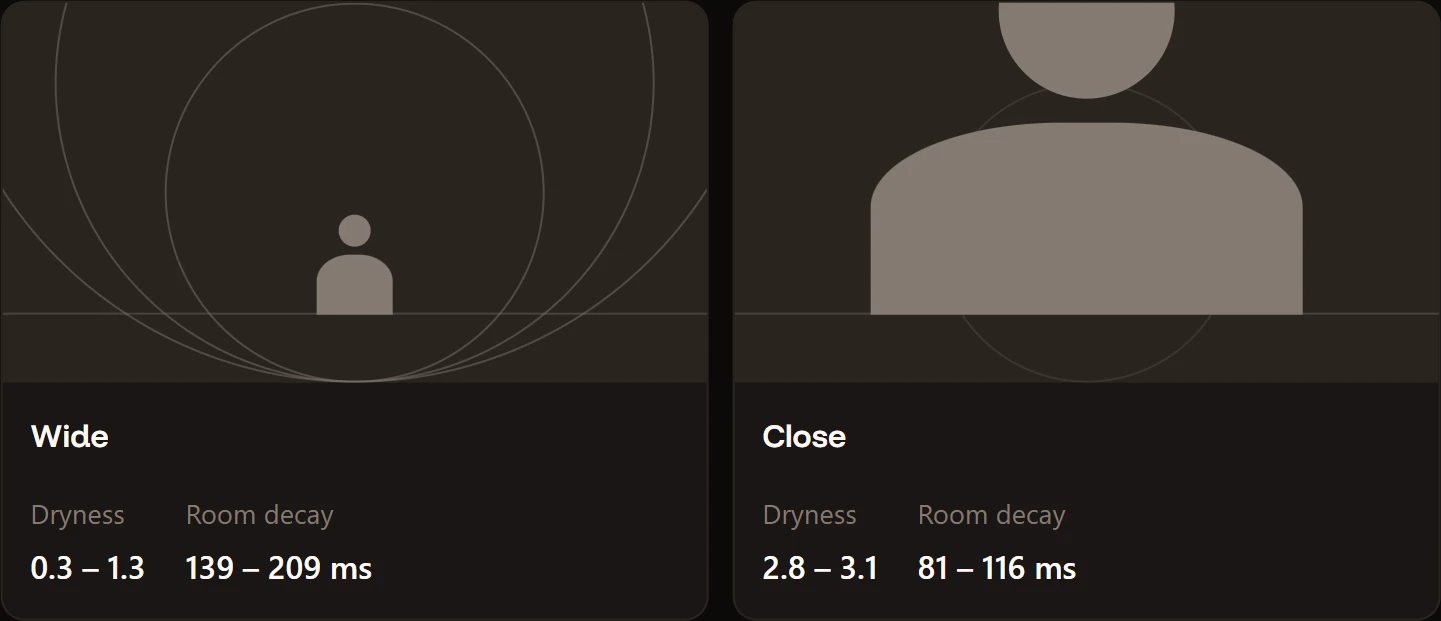
Les plans larges sont ceux qui ont de la résonance ; les deux plans rapprochés sont secs et intimes. Le modèle déduit l'acoustique à partir de la valeur de cadrage — une personne filmée depuis l'autre bout d'une pièce devrait sembler plus éloignée, il l'éloigne donc. C'est un bon instinct cinématographique. C'est aussi invisible jusqu'à ce que vous enchaîniez un moment en plan large et un plan rapproché, et que votre présentatrice semble se téléporter.
Peut-on corriger un audio vidéo IA incohérent en postproduction ?
Les deux tiers. Nous avons créé une chaîne d'égalisation et l'avons mesurée en toute honnêteté.
| Avant | Après | |
|---|---|---|
| Écart de volume sonore | 9,4 LU | 0,4 LU |
| Écart de timbre | 2,9 dB | 1,1 dB |
| Écart d'acoustique | 2,3 dB | inchangé |
La normalisation du volume en deux passes vers une cible unique élimine entièrement le problème de volume. Cela ne coûte rien et vous devriez le faire dans tous les cas. Mesurez chaque clip, puis corrigez-le avec les valeurs renvoyées par cette mesure, en utilisant une cible unique pour chaque clip du montage :
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
Un léger égaliseur en plateau par clip permet d'harmoniser en grande partie le timbre.
La réverbération est celle qui ne cède pas. Nous avons ajouté une petite pièce commune à chaque clip pour qu'ils partagent une même traîne, et cela a aggravé l'écart, le faisant passer de 2,3 dB à 2,9 dB : une réverbération partagée s'ajoute à la traîne existante de chaque clip au lieu de la remplacer. Harmoniser la réverbération ne fonctionne que vers le bas, en la supprimant, ce qui nécessite un outil de déréverbération dédié plutôt qu'une chaîne de filtres.
La réponse honnête à « puis-je le corriger en postproduction ? » est donc : les deux tiers oui, gratuitement. Le dernier tiers coûte moins cher à éviter qu'à réparer.
Comment maintenir la cohérence vocale d'une présentatrice IA d'un clip à l'autre ?
Une discipline de cadrage, pas d'audio. Conservez chaque prise de parole à la même distance de prise de vue et l'acoustique de la pièce cessera de changer, car on ne demande plus au modèle de la modifier.
Nous sommes arrivés à la même conclusion par un autre chemin. En faisant passer chaque clip par un modèle de compréhension vidéo comme contrôle qualité, les gros plans ont obtenu une note de 7 sur 10 pour la synchronisation labiale sans aucun décalage ; les plans larges ont obtenu entre 4 et 6 avec un décalage de 40 à 100 ms. Son explication : avec un cadrage large, le visage est petit, si bien que les mouvements de la bouche manquent de netteté.
Deux mesures indépendantes, une seule réponse : filmez votre présentatrice générée en gros plan, et gardez-la ainsi. Utilisez des plans larges pour le mouvement, pour le décor, pour tout moment où elle ne parle pas. Si vous avez besoin d'une acoustique encore plus stable, décrivez-la plutôt que de la laisser être déduite. Chaque prompt demande désormais une voix proche du micro et sèche, comme avec un micro-cravate placé à une largeur de main, sans écho de pièce.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
Comment vérifier automatiquement la synchronisation labiale de l'IA ?
Laissez un modèle l'évaluer pour vous. Les modèles modernes de compréhension vidéo — tout modèle multimodal actuel acceptant la vidéo — vont visionner un clip et évaluer la synchronisation labiale, transformant une discussion subjective en une liste de contrôle. Le nôtre a repéré une consonne bilabiale qui ne se fermait jamais tout à fait, un reflet de miroir en arrière-plan qui ne s'animait pas avec le premier plan, et un clin d'œil non demandé que le modèle avait ajouté de lui-même. Il a également estimé le décalage audio en millisecondes, ce qui est exactement le chiffre dont vous avez besoin pour choisir entre deux options. Pour comprendre comment fonctionnent les modèles de synchronisation labiale, consultez explication de la technologie de synchronisation labiale par IA.
Un avertissement : le choix du modèle compte plus que vous ne le pensez. Un modèle plus ancien attribuait la même note de 6 sur 10 à chaque clip et refusait d'estimer le moindre décalage — inutile pour effectuer un classement. Un modèle plus récent les a séparés clairement et a fourni les décalages. Si votre outil de contrôle indique que tout est identique, remettez-le en question.
Lorsque le contrôle qualité signale un mauvais détail dans une prise par ailleurs réussie, éditez le clip plutôt que de le régénérer.
En résumé
- Mesurez avant de relancer une génération. L'écart entre les scènes identifie l'étape défaillante dans un seul tableau.
- Votre synthèse vocale n'est probablement pas en cause.
- Certains modèles vidéo transmettent votre audio sans modification ; d'autres le rechantent. Seedance 2.5 le rechante ; Wan 3.0 a transmis le nôtre intact. Cela détermine si vous pourrez réinsérer la piste propre par la suite.
- La normalisation du volume est gratuite et résout le problème le plus important.
- La réverbération ne se corrige pas en ajoutant de la réverbération. Nous avons vérifié.
- Filmez les séquences parlées de près et conservez une distance constante. Cela corrige à la fois l'acoustique et la synchronisation labiale.
Chaque chiffre de cette page a été mesuré sur nos propres prises, générées avec Popcraft. L'illustration de couverture trace les données de volume du premier tableau. Méthode : hauteur vocale via pYIN sur les trames voisées, volume via le mesureur EBU R128, sécheresse définie comme le rapport entre les 50 premières ms de chaque début de parole et les 150 ms suivantes, décroissance mesurée comme le temps nécessaire pour chuter de 20 dB après l'arrêt de la parole.