Versi singkatnya. Jika suara presenter AI Anda berubah dari klip ke klip, kemungkinan besar text-to-speech bukanlah masalahnya — melainkan model videonya. Seedance 2.5 menyanyikan ulang sulih suara Anda pada setiap pengambilan, dan memilih akustik ruang dari ukuran pengambilan. Normalisasikan kenyaringan ke satu target, pertahankan setiap ketukan bicara pada jarak pengambilan yang sama, dan ketika berkas suara asli harus dipertahankan, hasilkan di Wan 3.0, yang meloloskan audio kami tanpa diubah.
Kami mengukur lima hal pada empat adegan tutorial dengan presenter hasil generate, dan ternyata text-to-speech tidak bersalah.
Satu wanita, satu ruangan, satu suara, dua belas menit materi. Setiap klip terlihat bagus secara terpisah. Potong dan gabungkan semuanya dan suaranya menjadi berantakan: cerah dan dekat di satu pengambilan, teredam dan jauh di pengambilan berikutnya, seolah-olah dia telah berkeliaran antara bilik podcast dan dapur seseorang di tengah kalimat.
Mengapa presenter AI terdengar berbeda di setiap klip?
Berhenti menebak-nebak dulu. Mengulang pengambilan sampai suaranya pas itu mahal dan tidak memberi tahu Anda apa pun. Jadi kami mengukur lima hal yang sama pada sumber text-to-speech dan pada audio yang sudah jadi, di empat adegan: pitch, kecerahan spektral, kenyaringan terintegrasi, dasar kebisingan, dan tingkat ucapan. Satu tabel menceritakan keseluruhan kisahnya.
| Rentangan antaradegan | Sumber text-to-speech | Audio klip akhir |
|---|---|---|
| Kenyaringan | 0.5 LU | 9.4 LU |
| Level ucapan | 2.5 dB | 8.3 dB |
| Pitch (median F0) | 17.3 Hz | 9.5 Hz |
| Room tone (noise floor) | 10.6 dB | 4.8 dB |
Rentangan = adegan paling keras hingga paling pelan, pitch tertinggi hingga terendah.
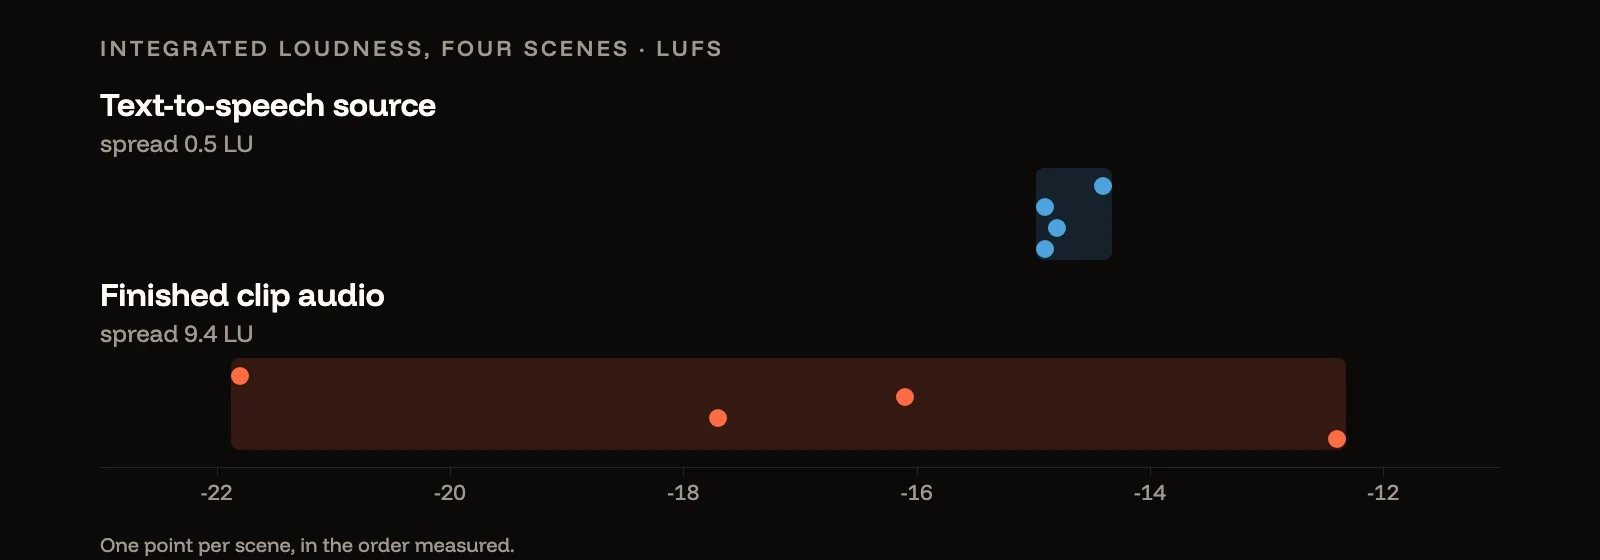
Text-to-speech-nya nyaris sempurna: empat adegan pada −14.4, −14.9, −14.8, dan −14.9 LUFS. Model video menghasilkan −21.8, −16.1, −17.7, dan −12.4. Ayunan sembilan setengah desibel itulah yang sebenarnya dimaksud dengan "suaranya terdengar berbeda di setiap cut".
Perhatikan dua baris yang bergerak ke arah sebaliknya. Pitch dan room tone justru lebih konsisten setelah melalui model video daripada sebelumnya. Hal yang kita kira mengalami drift ternyata tidak berubah sama sekali.
Apakah model video menggunakan voiceover Anda, atau membuatnya ulang?
Beberapa model menggunakannya. Beberapa model menyanyikannya lagi. Inilah temuan yang mengubah pipeline kami. Kami melakukan korelasi silang antara audio sumber dengan audio yang disematkan di setiap klip akhir, lalu memeriksa apakah keselarasannya tetap terjaga.
| Model | Korelasi dengan sumber | Drift di sepanjang klip |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 mengembalikan waveform Anda, yang digeser oleh jeda tetap. Seedance 2.5 mengembalikan performa baru: dikondisikan pada referensi Anda, karakternya jelas sama, tetapi disintesis ulang. Jika diukur terhadap sumber, model ini menurunkan pitch sebesar 0.2 hingga 1.3 semitone dan menggelapkan timbre sebesar 5 hingga 19 persen, dengan cara yang berbeda pada setiap take.
Untuk model yang menyanyikan ulang, ada dua konsekuensi yang muncul, dan keduanya sama-sama penting.
Tidak ada prompt yang bisa memperbaikinya. Variasi ini terjadi di dalam sintesis audio model, bukan pada apa pun yang bisa Anda deskripsikan. Kami sempat menghabiskan waktu menulis instruksi yang cermat tentang room tone yang konsisten sebelum menyadari bahwa room tone-nya sudah konsisten sejak awal.
Anda tidak bisa memasukkan kembali audio bersihnya. Ini tampak seperti perbaikan yang sempurna — pertahankan gambar yang bagus, masukkan trek suara asli Anda yang jernih di bawahnya — namun pada Seedance ini gagal, karena gerakan bibir mengikuti performa model yang telah disesuaikan waktunya sendiri, yang telah mengalami drift hingga 440 ms dari file Anda pada akhir klip.
Model mana yang sebaiknya Anda gunakan untuk presenter yang berbicara?
Tentukan apa yang harus tetap bertahan dari proses generasi.
- File suara aslinya harus tetap bertahan — suara brand yang dikloning, naskah yang harus diucapkan kata demi kata, atau voiceover yang telah disetujui klien. Gunakan Wan 3.0. Outputnya tetap terkunci pada file Anda dengan offset tetap, sehingga Anda bisa menghilangkan jeda dan meletakkan kembali trek aslinya di bawah gambar. Referensi audio dibatasi maksimal 15 detik total per permintaan, jadi rencanakan ketukan bicara dalam potongan sepanjang itu.
- Performanya boleh berubah — bacaan model itu sendiri dapat diterima, dan Anda lebih peduli pada pengambilan gambar daripada waveform yang persis sama. Seedance 2.5 sudah cukup, dan sisa postingan ini menjelaskan cara menjaga agar take-nya tetap selaras.
Bagaimanapun juga, suaranya sendiri dimulai dari generator text-to-speech; sumber yang konsisten adalah satu-satunya bagian yang tidak pernah menjadi masalah.
Mengapa host AI terdengar jauh pada wide shot?
Model menyesuaikan akustik ruangan dengan pengambilan gambar. Nuansa booth podcast versus dapur berasal dari akustik ruangannya, jadi kami mengukur rasio langsung-terhadap-reverberan — seberapa kering dan dekat suara terdengar dibandingkan dengan seberapa banyak akustik ruangan di sekitarnya — serta waktu peluruhan setelah setiap frasa.
| Adegan | Framing | Kekeringan | Peluruhan ruangan |
|---|---|---|---|
| Momen pengakuan | Close | 2.8 | 116 ms |
| Perkenalan | Close | 3.1 | 81 ms |
| Pembukaan | Wide | 1.3 | 139 ms |
| Penutup | Wide | 0.3 | 209 ms |
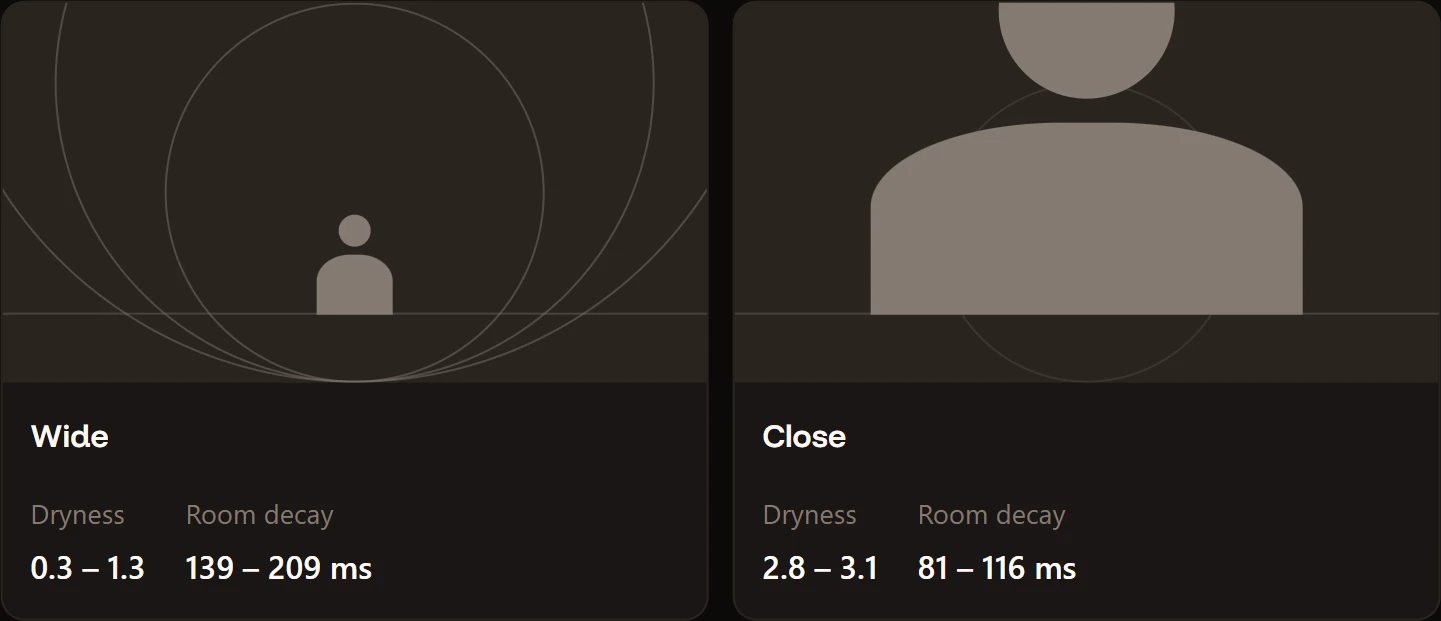
Wide shot adalah pengambilan gambar yang luas; kedua close shot terdengar kering dan intim. Model menyimpulkan akustik dari ukuran pengambilan gambar — seseorang yang direkam dari seberang ruangan seharusnya terdengar lebih jauh, jadi model menempatkannya lebih jauh. Itu adalah insting pembuatan film yang bagus. Namun, hal ini juga tidak terlihat sampai Anda memotong momen wide berhadapan dengan momen close dan presenter Anda tampak seperti berteleportasi.
Bisakah Anda memperbaiki audio video AI yang tidak konsisten di pascaproduksi?
Dua pertiganya. Kami membangun alur pencocokan dan mengukurnya secara objektif.
| Sebelum | Sesudah | |
|---|---|---|
| Sebaran kenyaringan | 9.4 LU | 0.4 LU |
| Sebaran timbre | 2.9 dB | 1.1 dB |
| Sebaran ruangan | 2.3 dB | tidak berubah |
Normalisasi kenyaringan dua tahap ke satu target tunggal menghilangkan masalah kenyaringan sepenuhnya. Ini tidak memakan biaya apa pun dan Anda tetap harus melakukannya. Ukur setiap klip, lalu perbaiki dengan angka yang dihasilkan pengukuran tersebut, menggunakan satu target untuk setiap klip dalam editan:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
EQ shelf per klip yang lembut menyelaraskan timbre hampir sepenuhnya.
Reverb adalah satu-satunya yang tidak bisa dikompromikan. Kami menambahkan simulasi ruangan bersama yang kecil ke setiap klip agar memiliki satu ekor suara yang sama, dan itu justru membuat sebarannya lebih buruk, dari 2.3 dB menjadi 2.9 dB: reverb bersama menambah ekor suara yang sudah ada pada setiap klip alih-alih menggantikannya. Pencocokan reverb hanya bisa dilakukan dengan cara mengurangi, dan itu memerlukan alat dereverb khusus alih-alih sekadar rantai filter.
Jadi jawaban jujur untuk "bisakah saya memperbaikinya di pascaproduksi" adalah: dua pertiganya, ya, secara gratis. Sepertiga sisanya lebih murah untuk dihindari daripada diperbaiki.
Bagaimana cara menjaga suara presenter AI tetap konsisten di berbagai klip?
Disiplin framing, bukan audio. Jaga setiap adegan berbicara pada jarak bidikan yang sama dan karakter ruangan akan berhenti berubah, karena model tidak lagi diminta untuk mengubahnya.
Kami mencapai kesimpulan yang sama dari arah yang berbeda. Dengan memproses setiap klip melalui model pemahaman video sebagai gerbang kualitas, bidikan dekat mendapat skor 7 dari 10 untuk sinkronisasi bibir dengan offset nol; bidikan lebar mendapat skor 4 hingga 6 dengan offset 40 hingga 100 ms. Penjelasannya: pada framing lebar, wajah terlihat kecil, sehingga bentuk mulut terbaca sebagai gumaman yang tidak jelas.
Dua pengukuran independen, satu jawaban: bidik presenter hasil generate Anda dari dekat, dan pertahankan posisinya. Gunakan bidikan lebar untuk pergerakan, untuk memperlihatkan ruangan, atau untuk apa pun saat ia tidak berbicara. Jika Anda membutuhkan akustik yang lebih stabil lagi, deskripsikan secara eksplisit alih-alih membiarkannya disimpulkan sendiri. Setiap prompt kini meminta suara yang dekat dan kering ke mikrofon, seolah-olah menggunakan mikrofon jepit sejarak satu telapak tangan, tanpa gema ruangan.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
Bagaimana cara memeriksa sinkronisasi bibir AI secara otomatis?
Biarkan model yang menilainya untuk Anda. Model pemahaman video modern — model multimodal apa pun saat ini yang menerima video — akan menonton klip dan menilai sinkronisasi bibir, yang mengubah argumen subjektif menjadi daftar periksa. Model kami menangkap konsonan bilabial yang tidak tertutup sempurna, pantulan cermin di latar belakang yang tidak beranimasi seiring dengan latar depan, dan kedipan tak terduga yang ditambahkan model dengan sendirinya. Model ini juga memperkirakan offset audio dalam milidetik, yang merupakan angka pasti yang Anda butuhkan untuk memilih di antara dua jalur. Untuk cara kerja model sinkronisasi bibir pada dasarnya, lihat Teknologi sinkronisasi bibir AI dijelaskan.
Satu peringatan: pilihan model lebih penting dari yang Anda duga. Model yang lebih lama menilai setiap klip secara identik pada angka 6 dari 10 dan menolak untuk memperkirakan offset apa pun — tidak berguna untuk pemeringkatan. Model yang lebih baru memisahkannya dengan jelas dan memberikan nilai offsetnya. Jika gerbang Anda mengatakan semuanya sama, curigai gerbang tersebut.
Ketika gerbang menandai satu detail buruk pada pengambilan yang sebenarnya bagus, edit klip tersebut alih-alih menghasilkan ulangnya.
Versi singkatnya
- Ukur sebelum Anda menghasilkan ulang. Sebaran antar adegan menunjukkan tahap mana yang bermasalah dalam satu tabel.
- Text-to-speech Anda mungkin tidak bersalah.
- Beberapa model video meneruskan audio Anda apa adanya; beberapa menyanyikannya ulang. Seedance 2.5 menyanyikan ulang; Wan 3.0 meneruskan audio kami apa adanya. Hal ini menentukan apakah Anda bisa memasukkan kembali trek bersihnya.
- Normalisasi kenyaringan itu gratis dan memperbaiki masalah terbesar.
- Reverb tidak bisa diperbaiki dengan menambahkan lebih banyak reverb. Kami sudah membuktikannya.
- Bidik adegan berbicara dari dekat dan jaga jaraknya tetap konstan. Ini memperbaiki akustik dan sinkronisasi bibir secara bersamaan.
Setiap angka di halaman ini diukur pada pengambilan kami sendiri, yang dihasilkan dengan Popcraft. Sampul memplot angka kenyaringan pada tabel pertama. Metode: pitch melalui pYIN pada frame bersuara, kenyaringan melalui meteran EBU R128, dryness sebagai rasio 50 ms pertama dari setiap awal ucapan terhadap 150 ms berikutnya, peluruhan sebagai waktu untuk turun 20 dB setelah ucapan berhenti.