結論から言うと。 AIプレゼンテーターの声がクリップごとに変わる場合、問題はおそらくテキスト読み上げではなくビデオモデルにあります。Seedance 2.5はテイクごとにボイスオーバーを再合成し、ショットサイズからルーム音響を選択します。ラウドネスを1つのターゲットにノーマライズし、すべての発話ビートを同じショット距離に保ち、正確な音声ファイルを維持する必要がある場合は、音声をそのまま通過させたWan 3.0で生成してください。
生成されたプレゼンテーターによるチュートリアルの4つのシーンで5つの項目を測定したところ、テキスト読み上げには問題がないことが判明しました。
1人の女性、1つの部屋、1つの声、12分の素材。各クリップは単体では良く見えました。しかし、それらを繋ぎ合わせると破綻しました。あるショットでは明るく近くに聞こえ、次のショットではこもって遠くに聞こえ、まるでポッドキャストのブースと誰かのキッチンとの間を会話の途中で彷徨っているかのようでした。
AIプレゼンテーターの声がクリップごとに違って聞こえるのはなぜですか?
まず推測するのはやめましょう。音が良くなるまでテイクを再生成するのはコストがかかり、何も教えてくれません。そこで、4つのシーンにわたって、テキスト読み上げのソースと完成した音声の同じ5つの項目、つまりピッチ、スペクトルブライトネス、インテグレーテッドラウドネス、ノイズフロア、スピーチレベルを測定しました。1つの表がすべてを物語っていました。
| シーン間のばらつき | テキスト読み上げソース | 完成したクリップの音声 |
|---|---|---|
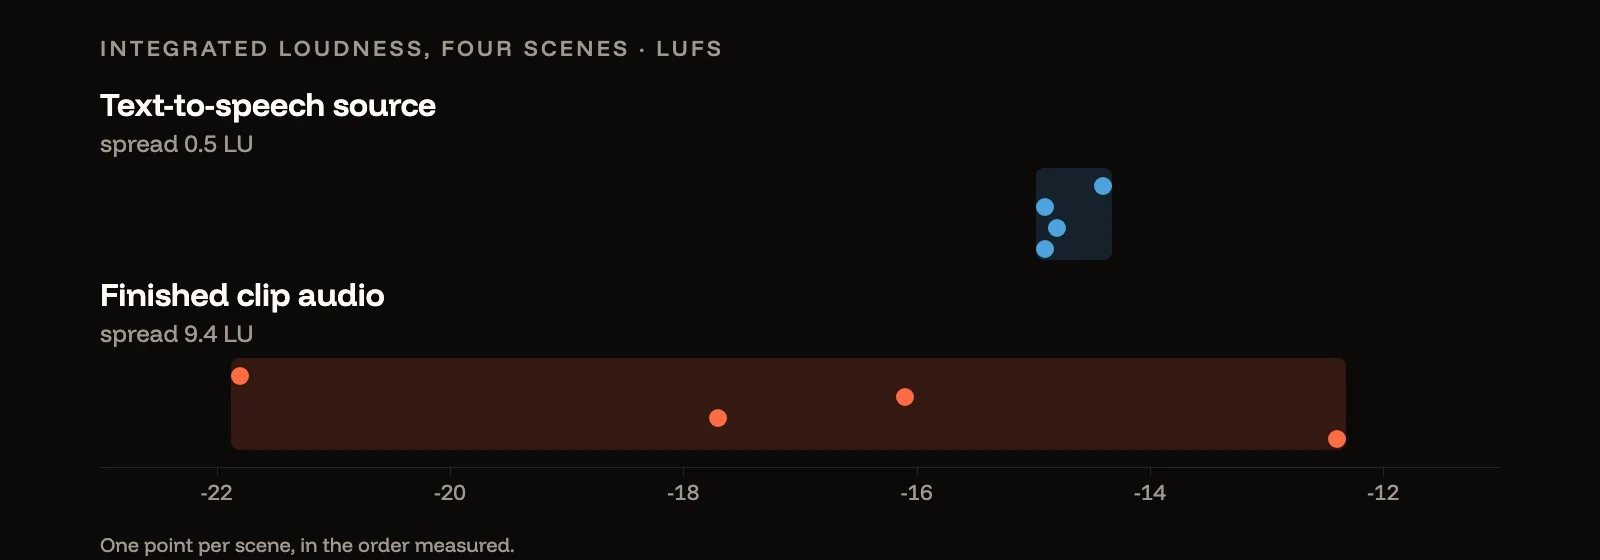
| ラウドネス | 0.5 LU | 9.4 LU |
| 音声レベル | 2.5 dB | 8.3 dB |
| ピッチ(中央値F0) | 17.3 Hz | 9.5 Hz |
| ルームトーン(ノイズフロア) | 10.6 dB | 4.8 dB |
ばらつき=最も音量が大きいシーンから最も静かなシーン、最もピッチが高いものから低いものまでの範囲。
テキスト読み上げはほぼ完璧でした。4つのシーンで−14.4、−14.9、−14.8、−14.9 LUFSという結果でした。しかし、ビデオモデルは−21.8、−16.1、−17.7、−12.4を返しました。この9.5デシベルもの変動こそが、「カットごとに彼女の声が違って聞こえる」現象の正体です。
逆の結果になっている2つの行に注目してください。ピッチとルームトーンは、ビデオモデルを通す前よりも通した後の方がより一貫していました。変動していると思い込んでいた要素は、実際には全く変動していなかったのです。
ビデオモデルはナレーションをそのまま使うのか、それとも再生成するのか?
一部のモデルはそのまま使用し、一部のモデルは再度読み上げます。これが私たちのパイプラインを変えることになった発見でした。私たちはソース音声と各完成クリップに埋め込まれた音声の相互相関を求め、その位置合わせが維持されているかどうかを確認しました。
| モデル | ソースとの相関 | クリップ全体でのドリフト |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0は、固定の遅延だけシフトさせた波形をそのまま返します。Seedance 2.5は新しいパフォーマンスを返します。あなたのリファレンスに基づき、明らかに同じキャラクターだと認識できるものの、再合成されたものです。ソースと比較して測定したところ、ピッチは0.2から1.3半音下がり、音色の暗さは5から19パーセント増加しており、しかもテイクごとに異なる結果となりました。
再読み上げを行うモデルの場合、2つの重要な結果が生じ、どちらも無視できません。
プロンプトでは修正できません。 バリエーションはモデルの音声合成内部で発生するものであり、あなたが指示できるものではありません。ルームトーンの一貫性について慎重に指示文を書くことに時間を費やしましたが、そもそもルームトーンは既に一貫していたことに後から気づきました。
クリーンな音声を後から差し戻すことはできません。 完璧な修正策のように見えます。良い映像はそのまま使い、その下にあなたの元のクリアな音声トラックを配置すればいい、というわけです。しかし、Seedanceではこれが失敗します。唇の動きはモデル独自のタイミング調整されたパフォーマンスに追従しており、クリップの終わりまでにあなたのファイルから最大440 msもずれてしまうからです。
喋るプレゼンターにはどのモデルを使うべきか?
生成プロセスを経て何が生き残る必要があるのかを決定します。
- 正確な音声ファイルがそのまま生き残る必要がある場合 — クローン化したブランドボイス、一言一句正確に伝えなければならないスクリプト、クライアントがすでに承認済みのナレーションなど。Wan 3.0を使用してください。出力は固定のオフセットであなたのファイルにロックされるため、遅延を除去して元のトラックを映像の下に再配置できます。音声リファレンスは1リクエストあたり合計15秒に制限されているため、トークのビートはその長さの断片に分割して計画してください。
- パフォーマンスが変動しても良い場合 — モデル独自の読み上げで許容でき、正確な波形よりもショットの出来を重視する場合。Seedance 2.5で問題ありません。この記事の残りの部分では、そのテイク間の一致を維持する方法を説明します。
いずれにせよ、音声自体はテキスト読み上げジェネレーターから始まります。一貫したソースを用意することは、そもそも問題ではなかった唯一の部分です。
ワイドショットでAIホストの声が遠く聞こえるのはなぜか?
モデルはショットに合わせて部屋の響きを一致させます。ポッドキャストのブースとキッチンでは違う印象を受けるのは部屋の響きによるものです。そこで、直接音と残響音の比率(声がどれだけドライで近くに聞こえるかに対し、周囲にどれだけ部屋の響きがあるか)と、各フレーズの後の減衰時間を測定しました。
| シーン | フレーミング | ドライネス | ルーム減衰 |
|---|---|---|---|
| 告白のビート | クローズ | 2.8 | 116 ms |
| 導入 | クローズ | 3.1 | 81 ms |
| オープニング | ワイド | 1.3 | 139 ms |
| クロージング | ワイド | 0.3 | 209 ms |
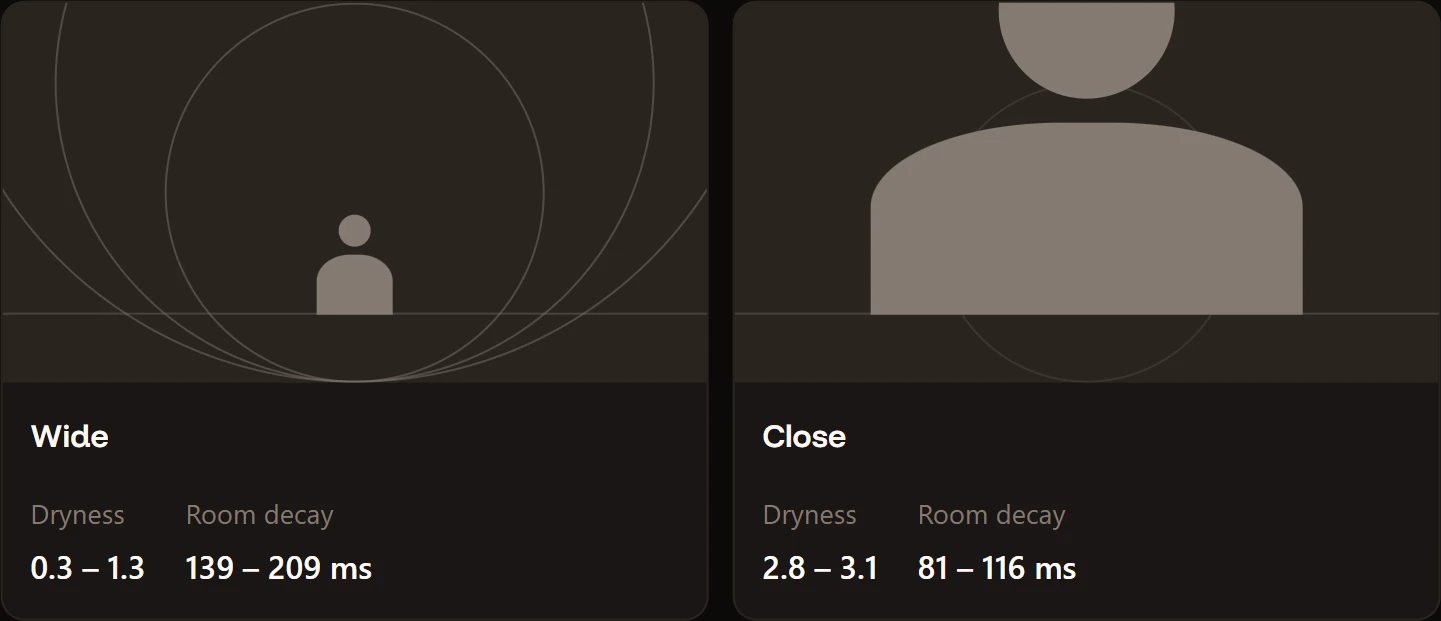
ワイドショットは響きが豊かで、両方のクローズショットはドライで親密な音です。モデルはショットサイズから音響特性を推測します。部屋の向こう側から撮影された人物は当然遠くから聞こえるはずなので、実際に音を遠ざけます。それは映像制作の本能として優れた判断です。しかし、ワイドのビートとクローズのビートをカットで繋ぐまでその事実は見えず、ホストが瞬間移動したかのように見えてしまうのです。
ポストプロダクションでAI動画の音声のばらつきは修正できるのでしょうか?
その3分の2です。私たちはマッチングチェーンを構築し、厳密に測定しました。
| 修正前 | 修正後 | |
|---|---|---|
| ラウドネスのばらつき | 9.4 LU | 0.4 LU |
| 音色のばらつき | 2.9 dB | 1.1 dB |
| ルームトーンのばらつき | 2.3 dB | 変化なし |
単一ターゲットへの2パスラウドネス正規化により、ラウドネスの問題は完全に解消されます。コストはかからず、とにかく行うべきです。各クリップを測定し、その測定で得られた数値を用いて、カット内のすべてのクリップに対して単一のターゲットを使用して修正してください。
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
各クリップに緩やかなシェルビングEQを適用することで、音色の大部分を揃えることができます。
リバーブだけはうまくいきません。すべてのクリップに小さな共通のルームリバーブを追加してテールを統一しようとしましたが、ばらつきは2.3 dBから2.9 dBへと、かえって悪化しました。共通のリバーブは、各クリップの既存のテールを置き換えるのではなく、上乗せしてしまうからです。リバーブのマッチングは、除去するという下方方向にしか機能せず、それにはフィルターチェーンではなく専用のデリーバーブツールが必要です。
したがって、「ポストプロダクションで修正できるか」という問いに対する正直な答えはこうです。3分の2は無料で修正可能です。残りの3分の1は、修正するよりも最初から避ける方が安上がりです。
クリップ間でAIプレゼンターの声の一貫性を保つにはどうすればよいでしょうか?
音声ではなく、フレーミングの規律です。すべての発話シーンを同じ撮影距離に保てば、部屋の特性は変わらなくなります。モデルに変更を求めなくなるからです。
私たちは別のアプローチから同じ結論に達しました。すべてのクリップを品質ゲートとして動画理解モデルに通したところ、クローズアップショットはリップシンクのスコアが10点満点中7点でオフセットはゼロでした。一方、ワイドショットは4点から6点で、40 msから100 msのオフセットがありました。その理由はこうです。ワイドフレーミングでは顔が小さく、口の形がぼやけて読み取れないからです。
2つの独立した測定から、1つの答えが出ました。生成したプレゼンターはクローズアップで撮影し、その距離を保ってください。ワイドショットは、動きや部屋全体、彼女が話していないシーンに使用します。音響をさらに安定させる必要がある場合は、モデルに推測させるのではなく、明示的に記述してください。現在、すべてのプロンプトで、手の幅ほど離れたラベリアマイクのように、部屋の残響のない、マイクに近くドライな声を求めています。
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
AIのリップシンクを自動的にチェックするにはどうすればよいでしょうか?
モデルに評価させましょう。最新の動画理解モデル、つまり動画を受け付ける現在のマルチモーダルモデルなら、クリップを見てリップシンクを評価し、主観的な議論をチェックリスト化してくれます。私たちのモデルは、完全に閉じきれていない両唇音を捉え、前景に合わせて動いていない背景の鏡の反射を検出し、モデルが勝手に追加した不要なウインクを見つけました。また、音声のオフセットをミリ秒単位で推定してくれましたが、これはまさに2つのルートのどちらを選ぶかに必要な数値です。リップシンクモデルの仕組みについては、AIリップシンク技術の解説をご覧ください。
1つ注意点があります。モデルの選択は予想以上に重要です。古いモデルはすべてのクリップを10点満点中6点と一律に評価し、オフセットの推定を拒否しました。ランキングには使えません。新しいモデルはそれらを明確に区別し、オフセットを提示してくれました。ゲートがすべて同じだと示す場合は、そのゲートを疑ってください。
ゲートが、それ以外は良好なテイクの中の1つの悪い詳細をフラグ立てした場合は、クリップを再生成する代わりに編集してください。
まとめ
- 再生成する前に測定してください。シーン間のばらつきを1つの表にすれば、どの段階に問題があるかが分かります。
- テキスト読み上げに問題はないはずです。
- 一部の動画モデルは音声をそのまま通しますが、一部は再合成します。Seedance 2.5は再合成し、Wan 3.0はそのまま通しました。これで、クリーンなトラックを後から差し替えられるかどうかが決まります。
- ラウドネス正規化は無料で、最大の問題を解決します。
- リバーブは、リバーブを追加しても修正できません。検証済みです。
- 発話シーンはクローズアップで撮影し、距離を一定に保ってください。音響とリップシンクが同時に修正されます。
このページのすべての数値は、Popcraftで生成した独自のテイクで測定されました。カバーには最初の表のラウドネス数値がプロットされています。手法:有声フレームでのpYINによるピッチ、EBU R128メーターによるラウドネス、各発話開始の最初の50 msとそれに続く150 msの比率としてのドライネス、発話停止後に20 dB低下するまでの時間としての減衰。