핵심 요약. AI 프레젠터의 목소리가 클립마다 달라진다면, 문제는 TTS가 아니라 비디오 모델일 가능성이 높습니다. Seedance 2.5는 테이크마다 더빙을 다시 생성하고, 숏 크기에 따라 공간 음향을 선택합니다. 음량을 하나의 타겟으로 정규화하고, 모든 대화 장면을 동일한 숏 거리로 유지하세요. 그리고 원본 음성 파일을 온전히 살려야 한다면, 저희 오디오를 변경 없이 통과시킨 Wan 3.0으로 생성하십시오.
저희는 생성된 프레젠터가 등장하는 튜토리얼의 4개 장면에서 5가지 요소를 측정했으며, 그 결과 TTS에는 문제가 없었음이 밝혀졌습니다.
한 명의 여성, 하나의 방, 하나의 목소리, 12분 분량의 소스. 각 클립은 개별적으로 보면 훌륭했습니다. 하지만 이들을 하나로 이어 붙이자 문제가 드러났습니다. 어떤 숏에서는 밝고 가깝게 들리다가, 다음 숏에서는 먹먹하고 멀리서 들렸는데, 마치 문장 도중에 팟캐스트 부스와 누군가의 주방을 오가며 녹음한 것 같았습니다.
AI 프레젠터의 목소리가 클립마다 다르게 들리는 이유는 무엇일까요?
일단 찍어보고 맞추려는 추측은 그만두세요. 소리가 괜찮아질 때까지 테이크를 다시 생성하는 것은 비용이 많이 들고 아무런 정보도 주지 못합니다. 그래서 저희는 4개의 장면에 걸쳐 TTS 원본과 완성된 오디오에서 피치, 스펙트럼 밝기, 통합 음량, 노이즈 플로어, 음성 레벨 등 동일한 5가지 요소를 측정했습니다. 단 하나의 표가 모든 것을 설명해 주었습니다.
| 장면 간 편차 | 텍스트 음성 변환 원본 | 완성된 클립 오디오 |
|---|---|---|
| 라우드니스 | 0.5 LU | 9.4 LU |
| 음성 레벨 | 2.5 dB | 8.3 dB |
| 피치(중앙값 F0) | 17.3 Hz | 9.5 Hz |
| 룸 톤(노이즈 플로어) | 10.6 dB | 4.8 dB |
편차 = 가장 소리 큰 장면부터 가장 조용한 장면까지, 가장 높은 피치부터 가장 낮은 피치까지.
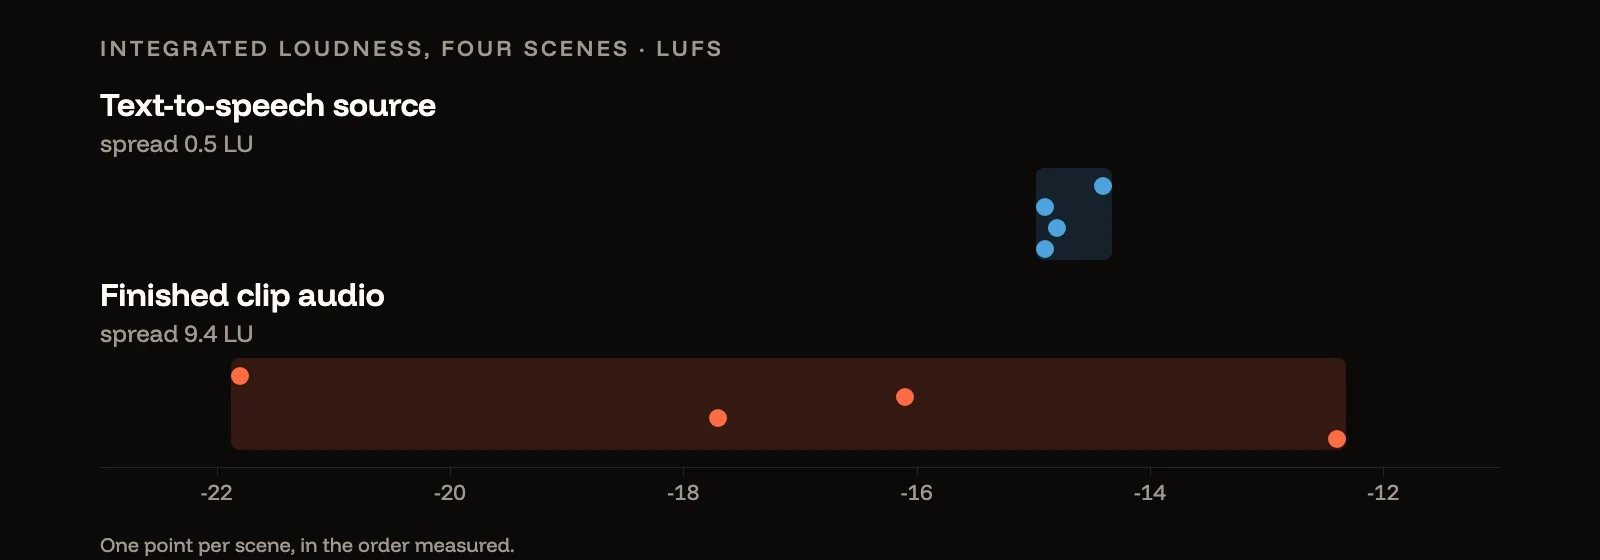
텍스트 음성 변환은 거의 완벽했습니다. 네 장면이 각각 −14.4, −14.9, −14.8, −14.9 LUFS였죠. 하지만 비디오 모델은 −21.8, −16.1, −17.7, −12.4를 반환했습니다. 바로 이 9.5데시벨의 편차가 '매 컷마다 목소리가 다르게 들리는' 현상의 실체입니다.
반대 방향으로 나타난 두 행을 주목해 보세요. 피치와 룸 톤은 비디오 모델 처리 전보다 오히려 더 일관성이 있었습니다. 우리가 변동되고 있다고 가정했던 것은 전혀 변동되지 않고 있었던 것입니다.
비디오 모델은 내레이션을 그대로 사용하나요, 아니면 다시 생성하나요?
어떤 모델은 원본을 그대로 사용하고, 어떤 모델은 다시 음성 합성을 합니다. 이것이 바로 저희 파이프라인을 바꾸게 된 발견이었습니다. 저희는 원본 오디오와 각 완성된 클립에 삽입된 오디오를 상호 상관 분석한 후, 정렬 상태가 유지되는지 확인했습니다.
| 모델 | 원본과의 상관관계 | 클립 전체의 드리프트 |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0은 고정된 지연 시간만큼 이동시킨 원본 파형을 그대로 반환합니다. Seedance 2.5는 새로운 퍼포먼스를 반환합니다. 참조 오디오를 기반으로 하여 확실히 같은 캐릭터로 인식되지만, 다시 합성된 목소리입니다. 원본과 비교해 측정한 결과, 피치는 0.2에서 1.3 반음 정도 낮아졌고 음색은 5에서 19퍼센트 정도 어두워졌으며, 이는 매 테이크마다 다르게 나타났습니다.
다시 음성 합성을 하는 모델의 경우 두 가지 중요한 결과가 따르며, 둘 다 간과할 수 없습니다.
어떤 프롬프트로도 이를 해결할 수 없습니다. 이 변동은 사용자가 설명할 수 있는 영역이 아닌 모델의 오디오 합성 내부에서 발생합니다. 저희는 룸 톤을 일정하게 유지하기 위해 신중하게 지시문을 작성하는 데 시간을 쏟았지만, 사실 룸 톤은 이미 일정하게 유지되고 있었다는 것을 뒤늦게 깨달았습니다.
깨끗한 원본 오디오로 다시 교체할 수도 없습니다. 완벽한 해결책처럼 보입니다. 좋은 영상은 유지하고 그 아래에 원본의 깨끗한 음성 트랙을 깔면 될 것 같지만, Seedance에서는 실패합니다. 입 모양이 모델 자체의 리타이밍된 퍼포먼스를 따르고 있기 때문이며, 이는 클립이 끝날 무렵 원본 파일에서 최대 440 ms까지 어긋나 있습니다.
말하는 진행자 영상에는 어떤 모델을 사용해야 할까요?
생성 과정에서 무엇이 반드시 보존되어야 할지 결정하세요.
- 정확한 음성 파일이 보존되어야 하는 경우 — 복제된 브랜드 보이스, 단어 하나까지 정확해야 하는 스크립트, 클라이언트가 이미 승인한 내레이션. Wan 3.0을 사용하세요. 결과물은 고정된 오프셋을 유지하며 원본 파일에 잠겨 나오므로, 지연 시간을 제거하고 영상 아래에 원본 트랙을 다시 깔 수 있습니다. 오디오 참조는 요청당 총 15초로 제한되므로, 말하는 구간을 그 길이에 맞춰 계획하세요.
- 퍼포먼스가 변해도 되는 경우 — 모델 자체의 읽기 방식도 허용 가능하며, 정확한 파형보다 영상 샷을 더 중요하게 생각하는 경우. Seedance 2.5도 좋으며, 이 글의 나머지 부분은 이 모델의 테이크를 일관되게 유지하는 방법에 대한 내용입니다.
어떤 방식을 선택하든, 음성 자체는 텍스트 음성 변환 생성기에서 시작됩니다. 일관된 원본 소스는 결코 문제가 되지 않았던 유일한 부분입니다.
와이드 샷에서 AI 진행자 목소리는 왜 멀리서 들릴까요?
모델은 샷에 맞춰 공간감을 일치시킵니다. 팟캐스트 부스와 주방의 느낌 차이는 공간감에서 오기 때문에, 저희는 직달음 대 잔향음 비율(목소리가 얼마나 드라이하고 가깝게 들리는지 대비 주변 공간감이 얼마나 있는지)과 각 문장 이후의 감쇠 시간을 측정했습니다.
| 장면 | 프레이밍 | 드라이니스 | 공간 감쇠 |
|---|---|---|---|
| 고백 장면 | 클로즈업 | 2.8 | 116 ms |
| 소개 | 클로즈업 | 3.1 | 81 ms |
| 오프닝 | 와이드 | 1.3 | 139 ms |
| 클로징 | 와이드 | 0.3 | 209 ms |
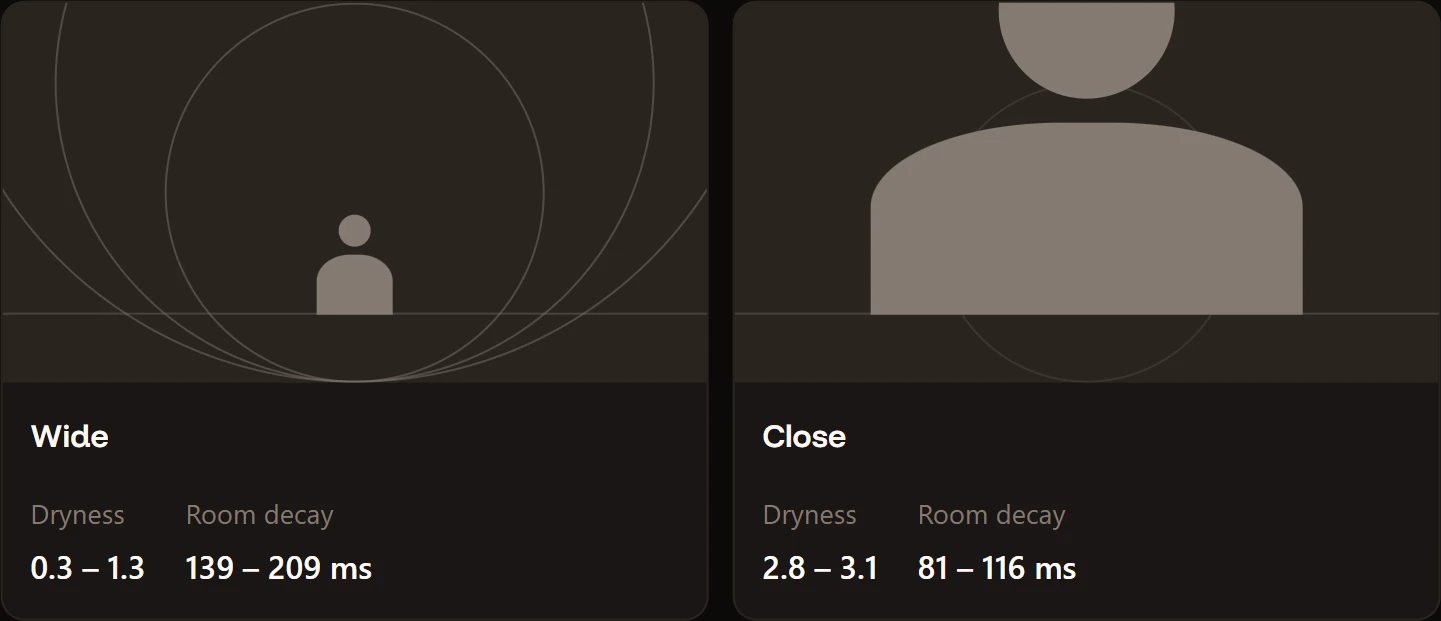
와이드 샷은 공간감이 넓고, 두 클로즈업 샷은 모두 드라이하고 친밀합니다. 모델은 샷의 크기에서 음향 특성을 추론합니다. 방 건너편에서 촬영한 사람은 당연히 더 멀리서 들려야 하므로, 소리를 더 멀리 배치하는 것입니다. 이는 훌륭한 영화 제작 본능입니다. 하지만 와이드 샷과 클로즈업 샷을 교차 편집하기 전까지는 눈에 띄지 않으며, 편집하는 순간 진행자가 순간이동한 것처럼 보이게 됩니다.
후반 작업에서 일관성 없는 AI 비디오 오디오를 수정할 수 있을까요?
그중 3분의 2는 가능합니다. 저희는 매칭 체인을 구축하고 정직하게 측정했습니다.
| 적용 전 | 적용 후 | |
|---|---|---|
| 라우드니스 편차 | 9.4 LU | 0.4 LU |
| 음색 편차 | 2.9 dB | 1.1 dB |
| 룸 편차 | 2.3 dB | 변화 없음 |
단일 타겟을 대상으로 한 2패스 라우드니스 정규화는 라우드니스 문제를 완전히 해결합니다. 비용이 들지 않으므로 무조건 적용해야 합니다. 각 클립을 측정한 다음, 측정된 수치를 바탕으로 컷의 모든 클립에 동일한 타겟을 사용하여 보정하십시오.
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
각 클립에 부드러운 셸프 EQ를 적용하면 음색을 대부분 일치시킬 수 있습니다.
리버브는 쉽게 해결되지 않는 문제입니다. 모든 클립이 하나의 테일을 공유하도록 작은 공유 룸을 추가해 보았지만, 편차가 2.3 dB에서 2.9 dB로 오히려 악화되었습니다. 공유 리버브는 각 클립의 기존 테일을 대체하는 것이 아니라 추가하기 때문입니다. 리버브를 일치시키는 작업은 리버브를 제거하는 방향으로만 가능하며, 이를 위해서는 필터 체인이 아닌 전용 디리버브 도구가 필요합니다.
따라서 "후반 작업에서 수정할 수 있을까요?"라는 질문에 대한 정직한 답변은 이렇습니다. 3분의 2는 무료로 수정 가능합니다. 나머지 3분의 1은 수정하는 것보다 애초에 피하는 것이 더 저렴합니다.
클립 전반에 걸쳐 AI 프레젠터의 음성을 일관되게 유지하려면 어떻게 해야 할까요?
오디오가 아닌 프레이밍 규율입니다. 모든 대화 장면을 동일한 촬영 거리로 유지하면 공간감이 바뀌지 않는데, 이는 모델에게 공간감을 바꾸라는 지시가 들어가지 않기 때문입니다.
저희는 다른 접근 방식을 통해 동일한 결론에 도달했습니다. 모든 클립을 품질 게이트로 비디오 이해 모델을 통과시켰을 때, 클로즈업 샷은 오프셋 0에 립싱크 점수 10점 만점에 7점을 기록한 반면, 와이드 샷은 40100 ms의 오프셋에 46점을 기록했습니다. 모델의 설명에 따르면, 와이드 프레이밍에서는 얼굴이 작아 입 모양이 뭉개져 보인다고 합니다.
두 가지 독립적인 측정, 하나의 결론: 생성된 프레젠터를 클로즈업으로 촬영하고 그 거리를 유지하십시오. 와이드 샷은 움직임, 공간, 프레젠터가 말하지 않는 장면에 사용하십시오. 음향 환경을 더 안정적으로 만들고 싶다면 모델이 추론하게 두지 말고 직접 설명하십시오. 이제 모든 프롬프트는 손 한 뼘 거리의 라발리에 마이크를 사용한 것처럼, 룸 에코 없이 마이크에 가깝고 드라이한 음성을 요구합니다.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
AI 립싱크를 자동으로 확인하려면 어떻게 해야 할까요?
모델이 대신 평가하게 하십시오. 최신 비디오 이해 모델, 즉 비디오를 입력받는 모든 최신 멀티모달 모델은 클립을 시청하고 립싱크를 평가하여 주관적인 논의를 체크리스트로 바꿀 수 있습니다. 저희 모델은 완전히 닫히지 않은 양순음을 포착했고, 전경과 함께 애니메이션되지 않은 배경 거울 반사를 찾아냈으며, 모델이 자체적으로 추가한 불필요한 윙크도 감지했습니다. 또한 오디오 오프셋을 밀리초 단위로 추정했는데, 이는 두 가지 경로 중 하나를 선택하는 데 필요한 정확한 수치입니다. 립싱크 모델의 기본 작동 원리에 대해서는 AI 립싱크 기술 설명을 참조하십시오.
한 가지 주의할 점: 모델 선택은 예상보다 훨씬 중요합니다. 구형 모델은 모든 클립을 동일하게 10점 만점에 6점으로 평가하고 오프셋 추정을 거부하여 순위 선정에 쓸모가 없었습니다. 최신 모델은 클립을 명확하게 구분하고 오프셋을 제공했습니다. 게이트가 모든 것을 동일하다고 판단한다면 게이트 자체를 의심해 보십시오.
게이트가 다른 부분은 다 좋은 테이크에서 하나의 잘못된 디테일을 지적하면, 클립을 다시 생성하는 대신 클립을 편집하십시오.
요약
- 다시 생성하기 전에 측정하십시오. 장면 간 편차를 표로 정리하면 어느 단계에 문제가 있는지 알 수 있습니다.
- 텍스트 음성 변환에는 아마 문제가 없을 것입니다.
- 일부 비디오 모델은 오디오를 그대로 통과시키는 반면, 일부는 다시 노래하듯 생성합니다. Seedance 2.5는 다시 생성하고, Wan 3.0은 저희 오디오를 그대로 통과시켰습니다. 이에 따라 깨끗한 트랙을 다시 교체할 수 있는지 여부가 결정됩니다.
- 라우드니스 정규화는 무료이며 가장 큰 문제를 해결합니다.
- 리버브는 리버브를 추가해서 해결할 수 없습니다. 저희가 확인해 보았습니다.
- 대화 장면은 클로즈업으로 촬영하고 거리를 일정하게 유지하십시오. 음향과 립싱크를 한 번에 해결할 수 있습니다.
이 페이지의 모든 수치는 Popcraft로 생성한 저희 테이크를 직접 측정한 것입니다. 커버 이미지는 첫 번째 표의 라우드니스 수치를 그래프로 나타냅니다. 방법: 유성음 프레임에서 pYIN을 통한 피치 추출, EBU R128 미터를 통한 라우드니스 측정, 각 발화 시작 후 처음 50 ms와 그다음 150 ms의 비율로 드라이니스 측정, 발화 종료 후 20 dB 하강하는 데 걸리는 시간으로 디케이 측정.