Versi ringkas. Jika suara penyampai AI anda berubah dari klip ke klip, teks-ke-pertuturan mungkin bukan puncanya — model video yang menjadi punca. Seedance 2.5 menyanyikan semula suara latar anda pada setiap rakaman, dan memilih akustik ruang daripada saiz syot. Normalkan kenyaringan ke satu sasaran, kekalkan setiap rentak pertuturan pada jarak syot yang sama, dan apabila fail suara yang tepat perlu dikekalkan, jana pada Wan 3.0, yang menyalurkan audio kami tanpa disentuh.
Kami mengukur lima perkara pada empat adegan tutorial dengan penyampai yang dijana, dan teks-ke-pertuturan ternyata tidak bersalah.
Seorang wanita, satu bilik, satu suara, dua belas minit bahan. Setiap klip kelihatan baik secara tersendiri. Satukan semuanya dan dia menjadi kucar-kacir: cerah dan dekat dalam satu syot, teredam dan jauh dalam syot seterusnya, seolah-olah dia telah merayau antara pondok podcast dan dapur seseorang di pertengahan ayat.
Mengapa penyampai AI kedengaran berbeza dalam setiap klip?
Berhenti meneka dahulu. Merakam semula secara berulang-ulang sehingga ia kedengaran betul adalah mahal dan tidak memberitahu anda apa-apa. Jadi kami mengukur lima perkara yang sama pada sumber teks-ke-pertuturan dan pada audio yang siap, merentasi empat adegan: pic, kecerahan spektrum, kenyaringan bersepadu, lantai hingar dan aras pertuturan. Satu jadual menceritakan keseluruhan kisah.
| Variasi antara adegan | Sumber teks-ke-ucapan | Audio klip siap |
|---|---|---|
| Kenyaringan | 0.5 LU | 9.4 LU |
| Tahap pertuturan | 2.5 dB | 8.3 dB |
| Nada (F0 median) | 17.3 Hz | 9.5 Hz |
| Tona bilik (lantai hingar) | 10.6 dB | 4.8 dB |
Variasi = adegan paling kuat hingga paling senyap, nada tertinggi hingga terendah.
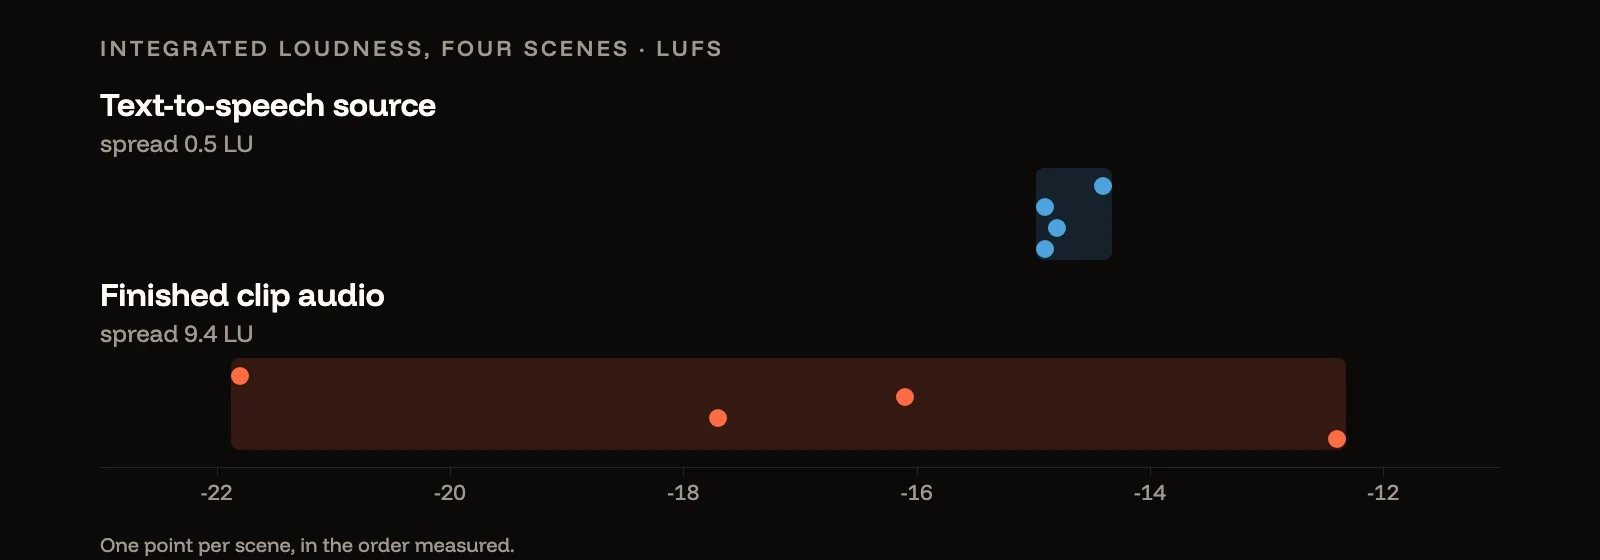
Teks-ke-ucapan itu hampir sempurna: empat adegan pada −14.4, −14.9, −14.8 dan −14.9 LUFS. Model video mengembalikan −21.8, −16.1, −17.7 dan −12.4. Ayunan sembilan setengah desibel itulah yang sebenarnya dimaksudkan dengan "dia kedengaran berbeza pada setiap potongan".
Perhatikan dua baris yang menunjukkan arah sebaliknya. Nada dan tona bilik adalah lebih konsisten selepas model video berbanding sebelumnya. Perkara yang kami anggap berubah-ubah sebenarnya tidak berubah langsung.
Adakah model video menggunakan suara latar anda, atau menjananya semula?
Sesetengah model menggunakannya. Sesetengah model menyanyikannya semula. Ini adalah penemuan yang mengubah aliran kerja kami. Kami mengkorelasi silang audio sumber dengan audio yang disematkan dalam setiap klip yang siap, kemudian menyemak sama ada penjajarannya kekal.
| Model | Korelasi dengan sumber | Hanyutan merentasi klip |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 mengembalikan bentuk gelombang anda, dianjakkan oleh lengahan tetap. Seedance 2.5 mengembalikan persembahan baharu: dikondisikan pada rujukan anda, watak yang sama yang dapat dikenali, tetapi disintesis semula. Diukur terhadap sumber, ia menarik nada turun sebanyak 0.2 hingga 1.3 semiton dan menggelapkan timbre sebanyak 5 hingga 19 peratus, secara berbeza pada setiap rakaman.
Bagi model yang menyanyikan semula, dua akibat akan menyusul, dan kedua-duanya penting.
Tiada gesaan yang akan membetulkannya. Variasi berlaku di dalam sintesis audio model, bukan dalam apa-apa yang boleh anda huraikan. Kami menghabiskan masa menulis arahan yang teliti tentang tona bilik yang konsisten sebelum menyedari bahawa tona bilik itu sememangnya sudah konsisten.
Anda tidak boleh memasukkan semula audio bersih. Ia kelihatan seperti penyelesaian yang sempurna — kekalkan gambar yang baik, letakkan trek suara asli anda di bawahnya — dan pada Seedance ia gagal, kerana pergerakan bibir mengikut persembahan model yang telah diselaraskan semula masanya, yang telah terhanyut sehingga 440 ms daripada fail anda pada penghujung klip.
Model manakah yang patut anda gunakan untuk penyampai yang bercakap?
Tentukan apa yang mesti dikekalkan selepas penjanaan.
- Fail suara yang tepat mesti dikekalkan — suara jenama yang diklon, skrip yang mesti disampaikan perkataan demi perkataan, suara latar yang telah diluluskan oleh klien. Gunakan Wan 3.0. Outputnya kekal terkunci pada fail anda pada ofset tetap, jadi anda boleh mengalih keluar lengahan dan meletakkan semula trek asal di bawah gambar. Rujukan audio dihadkan pada 15 saat secara keseluruhan bagi setiap permintaan, jadi rancangkan rentak pertuturan dalam bahagian sepanjang tempoh tersebut.
- Persembahan boleh berubah — bacaan model sendiri boleh diterima, dan anda lebih mementingkan rakaman berbanding bentuk gelombang yang tepat. Seedance 2.5 adalah sesuai, dan baki siaran ini menerangkan cara anda memastikan rakamannya kekal sepadan.
Apa-apa pun, suara itu sendiri bermula dalam penjana teks-ke-ucapan; sumber yang konsisten adalah satu-satunya bahagian yang tidak pernah menjadi masalah.
Mengapa penyampai AI kedengaran jauh dalam rakaman luas?
Model memadankan bilik dengan rakaman. Perasaan pondok podcast berbanding dapur datang dari bilik, jadi kami mengukur nisbah langsung-ke-gema — sejauh mana kering dan dekatnya suara berbanding berapa banyak ruang di sekelilingnya — dan masa susutan selepas setiap frasa.
| Adegan | Bingkai | Kekeringan | Susutan bilik |
|---|---|---|---|
| Rentak pengakuan | Dekat | 2.8 | 116 ms |
| Pengenalan | Dekat | 3.1 | 81 ms |
| Pembukaan | Luas | 1.3 | 139 ms |
| Penutup | Luas | 0.3 | 209 ms |
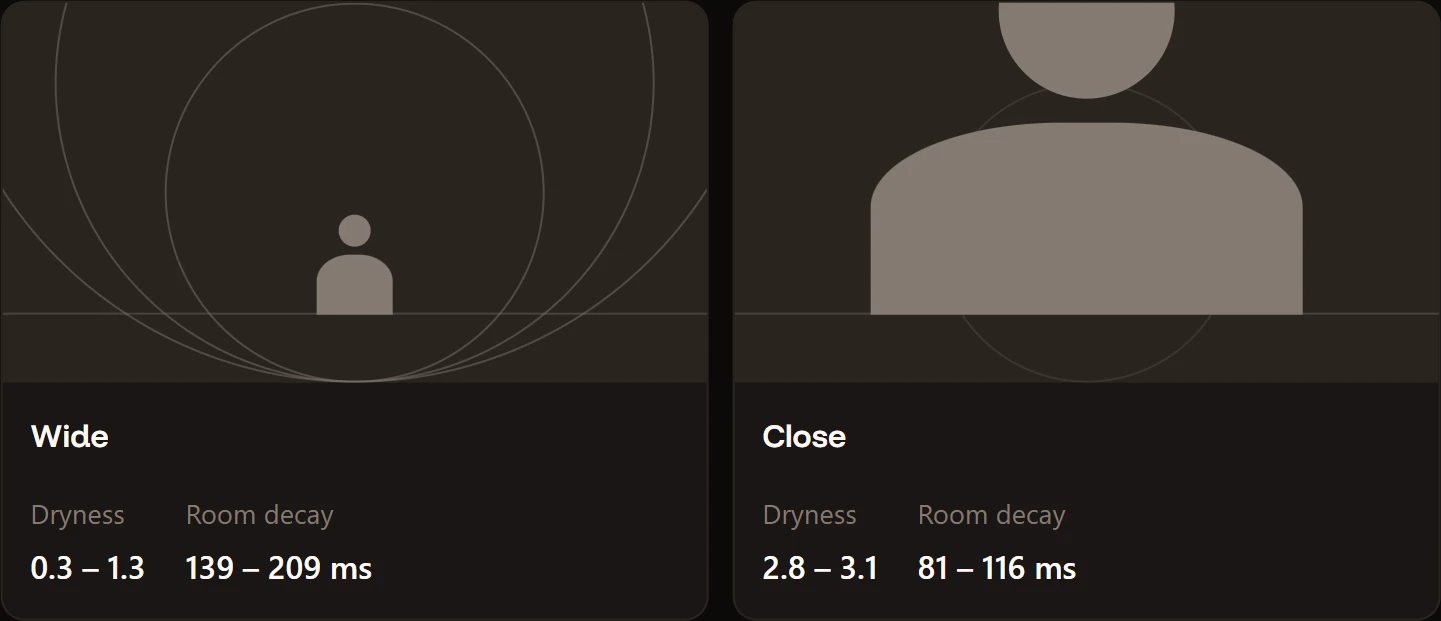
Rakaman luas adalah yang bergema; kedua-dua rakaman dekat adalah kering dan intim. Model membuat inferens akustik dari saiz rakaman — seseorang yang dirakam dari seberang bilik sepatutnya kedengaran lebih jauh, jadi ia meletakkan mereka lebih jauh. Itu adalah naluri pembikinan filem yang baik. Ia juga tidak kelihatan sehingga anda memotong rentak luas melawan rentak dekat dan penyampai anda kelihatan seperti teleportasi.
Bolehkah anda membaiki audio video AI yang tidak konsisten dalam pascaproduksi?
Dua pertiga daripadanya. Kami membina rantaian padanan dan mengukurnya dengan jujur.
| Sebelum | Selepas | |
|---|---|---|
| Sebaran kenyaringan | 9.4 LU | 0.4 LU |
| Sebaran timbre | 2.9 dB | 1.1 dB |
| Sebaran ruang | 2.3 dB | tidak berubah |
Normalisasi kenyaringan dua laluan ke sasaran tunggal menghapuskan masalah kenyaringan sepenuhnya. Ia tidak memerlukan sebarang kos dan anda patut melakukannya walau apa pun. Ukur setiap klip, kemudian betulkannya dengan angka yang dikembalikan oleh pengukuran tersebut, menggunakan satu sasaran untuk setiap klip dalam suntingan:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
EQ shelf lembut untuk setiap klip menyelaraskan timbre hampir sepenuhnya.
Reverb adalah satu-satunya yang tidak dapat diatasi. Kami menambah ruang kongsi kecil pada setiap klip supaya ia berkongsi satu ekor, dan ia menjadikan sebaran lebih teruk, dari 2.3 dB ke 2.9 dB: reverb kongsi menambah pada ekor sedia ada setiap klip dan bukannya menggantikannya. Padanan reverb hanya berkesan ke bawah, dengan membuangnya, dan itu memerlukan alat nyahreverb khusus dan bukannya rantaian penapis.
Jadi jawapan jujur kepada "bolehkah saya membetulkannya dalam pascaproduksi" ialah: dua pertiga daripadanya, ya, secara percuma. Satu pertiga terakhir adalah lebih murah untuk dielakkan daripada dibaiki.
Bagaimanakah anda mengekalkan suara penyampai AI yang konsisten merentasi klip?
Disiplin pembingkaian, bukan audio. Kekalkan setiap rentak pertuturan pada jarak syot yang sama dan karakter ruang akan berhenti berubah, kerana model tidak lagi diminta untuk mengubahnya.
Kami mencapai kesimpulan yang sama dari arah yang berbeza. Dengan menjalankan setiap klip melalui model pemahaman video sebagai gerbang kualiti, syot dekat mendapat skor 7 daripada 10 untuk segerak bibir dengan sifar ofset; syot luas mendapat skor 4 hingga 6 dengan ofset 40 hingga 100 ms. Penjelasan model: pada pembingkaian luas, wajah adalah kecil, jadi bentuk mulut kelihatan kabur.
Dua pengukuran bebas, satu jawapan: rakam penyampai janaan anda dari dekat, dan kekalkannya di situ. Gunakan syot luas untuk pergerakan, untuk ruang, untuk apa-apa sahaja di mana dia tidak bercakap. Jika anda memerlukan akustik yang lebih stabil, huraikannya dan bukannya membiarkannya disimpulkan. Setiap gesaan kini meminta suara yang dekat dan kering pada mikrofon, seolah-olah pada mikrofon lavalier selebar tangan, tanpa gema ruang.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
Bagaimanakah anda menyemak segerak bibir AI secara automatik?
Biarkan model menilainya untuk anda. Model pemahaman video moden — mana-mana model multimodal semasa yang menerima video — akan menonton klip dan menilai segerak bibir, yang mengubah hujah subjektif menjadi senarai semak. Model kami menangkap konsonan dwibibir yang tidak tertutup sepenuhnya, pantulan cermin latar belakang yang tidak beranimasi bersama latar depan, dan kenyitan yang tidak diminta yang telah ditambah oleh model itu sendiri. Ia juga menganggarkan ofset audio dalam milisaat, yang merupakan angka tepat yang anda perlukan untuk memilih antara dua laluan. Untuk cara model segerak bibir berfungsi, lihat Teknologi segerak bibir AI dijelaskan.
Satu amaran: pilihan model lebih penting daripada yang anda jangkakan. Model lama menilai setiap klip secara serupa pada 6 daripada 10 dan enggan menganggarkan sebarang ofset — tidak berguna untuk penarafan. Model yang lebih baharu memisahkannya dengan jelas dan memberikan ofset. Jika gerbang anda mengatakan semuanya sama, syakilah gerbang tersebut.
Apabila gerbang menandakan satu butiran buruk dalam rakaman yang sebaliknya baik, sunting klip tersebut dan bukannya menjana semula.
Versi ringkas
- Ukur sebelum anda jana semula. Sebaran merentasi adegan menamakan peringkat yang bersalah dalam satu jadual.
- Teks-ke-pertuturan anda mungkin tidak bersalah.
- Sesetengah model video meneruskan audio anda; sesetengah menyanyikannya semula. Seedance 2.5 menyanyikan semula; Wan 3.0 meneruskan audio kami. Itu menentukan sama ada anda boleh menukar kembali trek bersih.
- Normalisasi kenyaringan adalah percuma dan membaiki masalah terbesar.
- Reverb tidak boleh dibaiki dengan menambah lebih banyak reverb. Kami telah menyemaknya.
- Rakam rentak pertuturan dari dekat dan kekalkan jarak yang malar. Ia membaiki akustik dan segerak bibir serentak.
Setiap angka pada halaman ini diukur pada rakaman kami sendiri, dijana dengan Popcraft. Muka depan memplot angka kenyaringan dalam jadual pertama. Kaedah: pic melalui pYIN pada bingkai bersuara, kenyaringan melalui meter EBU R128, kekeringan sebagai nisbah 50 ms pertama setiap permulaan pertuturan kepada 150 ms berikutnya, susutan sebagai masa untuk jatuh 20 dB selepas pertuturan berhenti.