A versão curta. Se a voz da sua apresentadora de IA muda de clipe para clipe, o problema provavelmente não é a conversão de texto em fala, mas sim o modelo de vídeo. O Seedance 2.5 recanta a sua locução a cada take e escolhe a acústica do ambiente a partir do enquadramento. Normalize a sonoridade (loudness) para um único alvo, mantenha cada momento de fala na mesma distância de enquadramento e, quando o arquivo de voz exato tiver de ser preservado, gere no Wan 3.0, que manteve o nosso áudio intacto.
Medimos cinco elementos em quatro cenas de um tutorial com uma apresentadora gerada, e a conversão de texto em fala mostrou-se inocente.
Uma mulher, uma sala, uma voz, doze minutos de material. Cada clipe parecia bom isoladamente. Ao juntá-los na edição, ela desmoronava: brilhante e próxima em um plano, abafada e distante no seguinte, como se tivesse transitado entre uma cabine de podcast e a cozinha de alguém no meio da frase.
Por que uma apresentadora de IA soa diferente em cada clipe?
Pare de adivinhar antes de tudo. Gerar novamente os takes até que soem corretos é caro e não ensina nada. Por isso, medimos os mesmos cinco elementos na fonte de texto para fala e no áudio finalizado, ao longo de quatro cenas: pitch, brilho espectral, loudness integrado, ruído de fundo e nível da fala. Uma única tabela contou toda a história.
| Variação entre cenas | Fonte de texto para fala | Áudio do clipe finalizado |
|---|---|---|
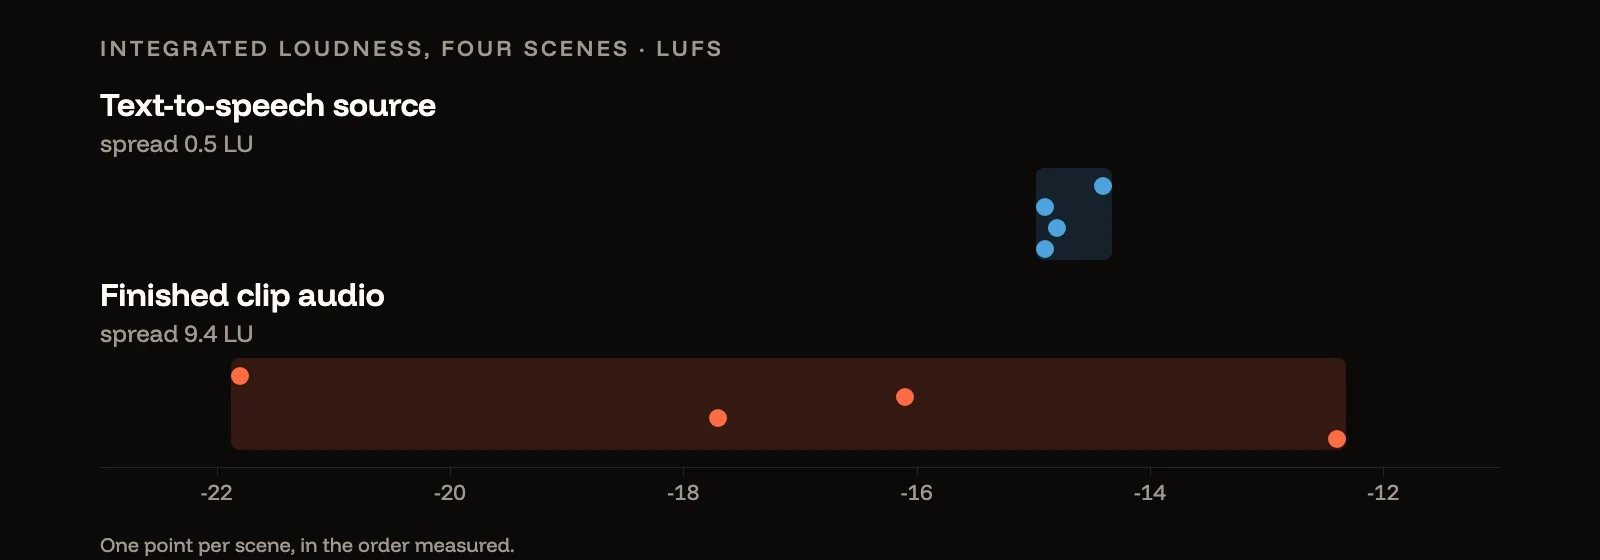
| Loudness | 0.5 LU | 9.4 LU |
| Nível de fala | 2.5 dB | 8.3 dB |
| Pitch (F0 mediano) | 17.3 Hz | 9.5 Hz |
| Som ambiente (ruído de fundo) | 10.6 dB | 4.8 dB |
Variação = da cena mais alta à mais silenciosa, do tom mais agudo ao mais grave.
O texto para fala estava quase perfeito: quatro cenas a −14.4, −14.9, −14.8 e −14.9 LUFS. O modelo de vídeo retornou −21.8, −16.1, −17.7 e −12.4. Essa variação de nove decibéis e meio é exatamente o que significa "ela soa diferente a cada corte".
Note as duas linhas que vão na direção oposta. O pitch e o som ambiente estavam mais consistentes depois do modelo de vídeo do que antes dele. O elemento que presumíamos estar oscilando não estava oscilando de forma alguma.
O modelo de vídeo usa a sua locução ou a gera novamente?
Alguns modelos o utilizam. Outros o cantam novamente. Essa foi a descoberta que mudou nosso fluxo de trabalho. Fizemos a correlação cruzada do áudio de origem com o áudio embutido em cada clipe finalizado e, em seguida, verificamos se o alinhamento se mantinha.
| Modelo | Correlação com a fonte | Desvio ao longo do clipe |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
O Wan 3.0 devolve a sua forma de onda, deslocada por um atraso fixo. O Seedance 2.5 devolve uma nova interpretação: condicionada à sua referência, reconhecivelmente a mesma personagem, mas ressintetizada. Medido em relação à fonte, reduziu o tom em 0.2 a 1.3 semitons e escureceu o timbre em 5 a 19 por cento, de forma diferente em cada take.
Para um modelo que recanta, há duas consequências, e ambas são importantes.
Nenhum prompt vai resolver isso. A variação ocorre dentro da síntese de áudio do modelo, e não em algo que você possa descrever. Passamos algum tempo escrevendo instruções detalhadas sobre um ruído de fundo (room tone) consistente antes de percebermos que o ruído de fundo já era consistente.
Você não pode simplesmente substituir pelo áudio limpo. Parecia a solução perfeita — manter a imagem boa e colocar a sua faixa de voz impecável por baixo —, mas no Seedance isso falha, porque os lábios acompanham a própria atuação reajustada do modelo, que sofreu um desvio de até 440 ms em relação ao seu arquivo até o final do clipe.
Qual modelo você deve usar para uma apresentadora falante?
Decida o que precisa ser mantido na geração.
- O arquivo de voz exato precisa ser mantido — uma voz de marca clonada, um roteiro que deve ser seguido palavra por palavra, uma locução que o cliente já aprovou. Use o Wan 3.0. O resultado dele permanece sincronizado com o seu arquivo a um atraso fixo, para que você possa remover a latência e recolocar a faixa original sob a imagem. As referências de áudio são limitadas a 15 segundos no total por solicitação, portanto planeje os momentos de fala em trechos dessa duração.
- A interpretação pode variar — a leitura do próprio modelo é aceitável e você se importa mais com o enquadramento do que com a forma de onda exata. O Seedance 2.5 funciona bem, e o restante deste artigo explica como manter os takes alinhados.
De qualquer forma, a própria voz começa no gerador de texto para fala; uma fonte consistente é a única parte que nunca foi o problema.
Por que uma apresentadora de IA soa distante em planos abertos?
O modelo ajusta a sala ao plano. A sensação de "cabine de podcast versus cozinha" vem da acústica da sala, por isso medimos a relação sinal direto-reverberado — o quão seca e próxima uma voz soa em comparação com o quanto de sala há ao redor dela — e o tempo de decaimento após cada frase.
| Cena | Enquadramento | Som seco | Decaimento da sala |
|---|---|---|---|
| Momento de confissão | Fechado | 2.8 | 116 ms |
| Introdução | Fechado | 3.1 | 81 ms |
| Abertura | Aberto | 1.3 | 139 ms |
| Encerramento | Aberto | 0.3 | 209 ms |
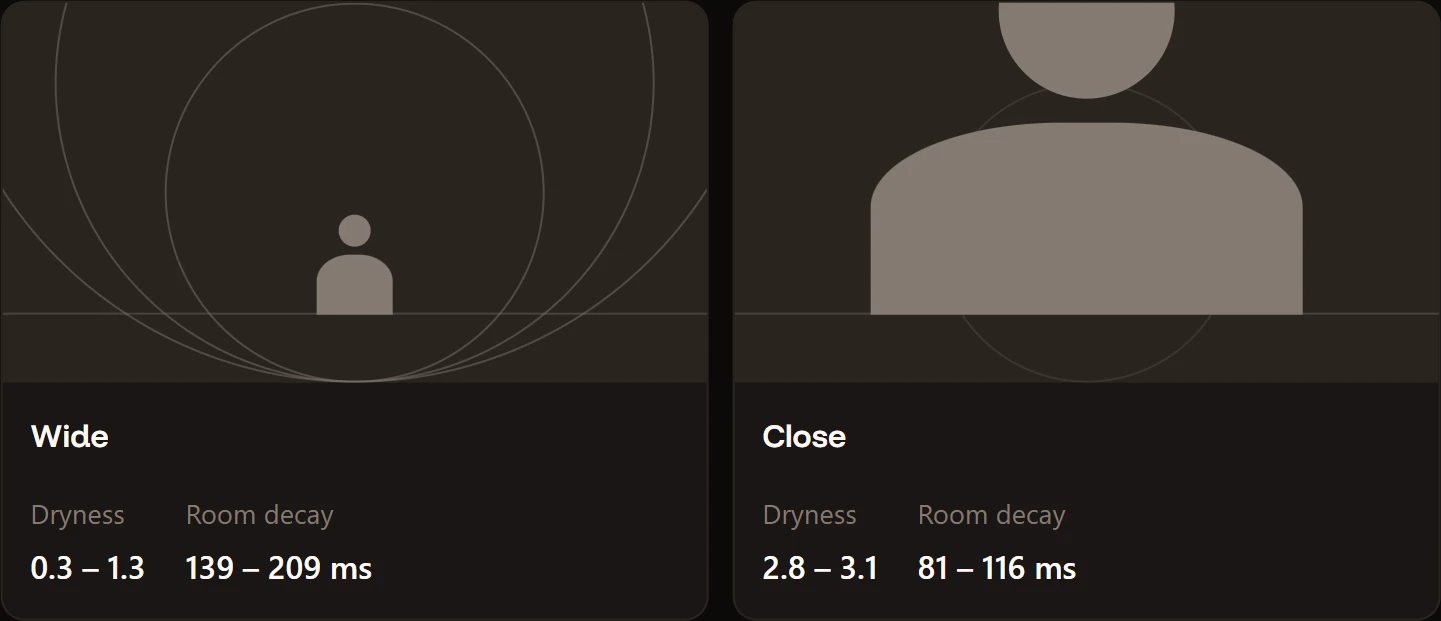
Os planos abertos são os que têm mais reverberação; ambos os planos fechados são secos e íntimos. O modelo deduz a acústica a partir do tamanho do plano — uma pessoa filmada do outro lado de uma sala deveria soar mais distante, então ele a coloca mais distante. Esse é um bom instinto cinematográfico. Também é invisível até você cortar um momento aberto contra um fechado e a sua apresentadora parecer teletransportar.
É possível corrigir o áudio inconsistente de um vídeo de IA na pós-produção?
Dois terços disso. Construímos uma cadeia de correspondência e a medimos com honestidade.
| Antes | Depois | |
|---|---|---|
| Variação de loudness | 9.4 LU | 0.4 LU |
| Variação de timbre | 2.9 dB | 1.1 dB |
| Variação de ambiente | 2.3 dB | inalterado |
A normalização de loudness em duas passagens para um único alvo elimina completamente o problema de loudness. Não custa nada e você deve fazê-la independentemente de tudo. Meça cada clipe e, em seguida, corrija-o com os valores obtidos nessa medição, usando um único alvo para todos os clipes do corte:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
Uma equalização shelf suave em cada clipe ajusta a maior parte do timbre.
A reverberação é o único elemento que não cede. Adicionamos uma pequena sala compartilhada a cada clipe para que compartilhassem a mesma cauda de áudio, e isso tornou a variação pior, de 2.3 dB para 2.9 dB: uma reverberação compartilhada se soma à cauda existente de cada clipe em vez de substituí-la. A combinação de reverberação só funciona para baixo, removendo-a, e isso exige uma ferramenta dedicada de dereverb em vez de uma cadeia de filtros.
Portanto, a resposta sincera para "posso corrigir isso na pós-produção?" é: dois terços sim, gratuitamente. O último terço é mais barato evitar do que reparar.
Como manter a voz de uma apresentadora de IA consistente entre os clipes?
Disciplina no enquadramento, não no áudio. Mantenha cada momento de fala na mesma distância de plano e o caráter da sala para de mudar, porque o modelo deixa de ser solicitado a mudá-lo.
Chegamos à mesma conclusão por outro caminho. Ao passar cada clipe por um modelo de compreensão de vídeo como controle de qualidade, os planos fechados obtiveram uma pontuação de 7 em 10 para sincronização labial, com zero desvio; os planos abertos obtiveram de 4 a 6, com 40 a 100 ms de desvio. A explicação do modelo: num enquadramento aberto, o rosto é pequeno, de modo que os movimentos da boca parecem indefinidos.
Duas medições independentes, uma resposta: grave a sua apresentadora gerada de perto e mantenha-a assim. Use planos abertos para movimento, para a sala, para qualquer momento em que ela não esteja falando. Se precisar que a acústica seja ainda mais estável, descreva-a em vez de deixar que seja inferida. Cada prompt pede agora uma voz próxima e seca em relação ao microfone, como se estivesse num microfone de lapela à distância de uma mão, sem eco da sala.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
Como verificar a sincronização labial da IA automaticamente?
Deixe um modelo avaliar por você. Modelos modernos de compreensão de vídeo — qualquer modelo multimodal atual que aceite vídeo — assistirão e avaliarão a sincronização labial de um clipe, transformando um argumento subjetivo em uma lista de verificação. O nosso identificou uma consoante bilabial que nunca fechava totalmente, o reflexo de um espelho ao fundo que não se animava junto com o primeiro plano e uma piscadela não solicitada que o modelo adicionou por conta própria. Ele também estimou o deslocamento de áudio em milissegundos, que é exatamente o número necessário para escolher entre dois caminhos. Para entender como os modelos de sincronização labial funcionam, consulte a tecnologia de sincronização labial por IA explicada.
Uma ressalva: a escolha do modelo importa mais do que você esperaria. Um modelo mais antigo avaliou cada clipe de forma idêntica como 6 de 10 e se recusou a estimar qualquer deslocamento — inútil para classificação. Um mais novo os separou nitidamente e forneceu os deslocamentos. Se a sua verificação diz que tudo é igual, suspeite da verificação.
Quando o controle de qualidade sinalizar um detalhe ruim em um take que, de resto, é bom, edite o clipe em vez de gerá-lo novamente.
A versão curta
- Meça antes de gerar novamente. A variação entre as cenas aponta a etapa com falha em uma única tabela.
- O seu conversor de texto em fala provavelmente não tem culpa.
- Alguns modelos de vídeo mantêm o seu áudio intacto; outros o recantam. O Seedance 2.5 recanta; o Wan 3.0 manteve o nosso intacto. Isso determina se você poderá substituir pela faixa limpa mais tarde.
- A normalização de sonoridade (loudness) é gratuita e resolve o maior problema.
- O reverbo não é corrigido adicionando mais reverbo. Nós testamos.
- Grave os momentos de fala em plano fechado e mantenha a distância constante. Isso corrige a acústica e a sincronização labial ao mesmo tempo.
Todos os números nesta página foram medidos em nossos próprios takes, gerados com o Popcraft. A capa ilustra os valores de sonoridade da primeira tabela. Método: tom (pitch) via pYIN nos quadros sonorizados, sonoridade (loudness) via medidor EBU R128, som seco como a relação entre os primeiros 50 ms do início da fala e os 150 ms seguintes, e decaimento como o tempo para queda de 20 dB após a fala parar.