Короткая версия. Если голос вашей ИИ-ведущей меняется от клипа к клипу, проблема, скорее всего, не в синтезе речи, а в видеомодели. Seedance 2.5 пересинтезирует вашу озвучку в каждом дубле и подбирает акустику помещения под крупность плана. Нормализуйте громкость к одному значению, держите все разговорные моменты на одной дистанции плана, а когда нужно сохранить точный файл голоса, генерируйте в Wan 3.0, которая пропустила наше аудио без изменений.
Мы измерили пять параметров в четырёх сценах туториала со сгенерированной ведущей, и синтез речи оказался невиновен.
Одна женщина, одна комната, один голос, двенадцать минут материала. Каждый клип сам по себе выглядел хорошо. Но при склейке всё разваливалось: ярко и близко в одном кадре, глухо и далеко в другом, словно она бродила между подкаст-студией и чьей-то кухней прямо посреди фразы.
Почему ИИ-ведущая звучит по-разному в каждом ролике?
Перестаньте гадать. Перегенерация дублей до идеального звука стоит дорого и ничего не даёт. Поэтому мы измерили те же пять параметров на источнике синтеза речи и на готовом аудио в четырёх сценах: высоту тона, спектральную яркость, интегральную громкость, уровень шума и уровень речи. Одна таблица рассказала всю историю.
| Разброс между сценами | Исходный синтез речи | Аудио готового клипа |
|---|---|---|
| Громкость | 0.5 LU | 9.4 LU |
| Уровень речи | 2.5 dB | 8.3 dB |
| Высота тона (медианная F0) | 17.3 Hz | 9.5 Hz |
| Фоновый шум комнаты (порог шума) | 10.6 dB | 4.8 dB |
Разброс = от самой громкой сцены к самой тихой, от самой высокой высоты тона к самой низкой.
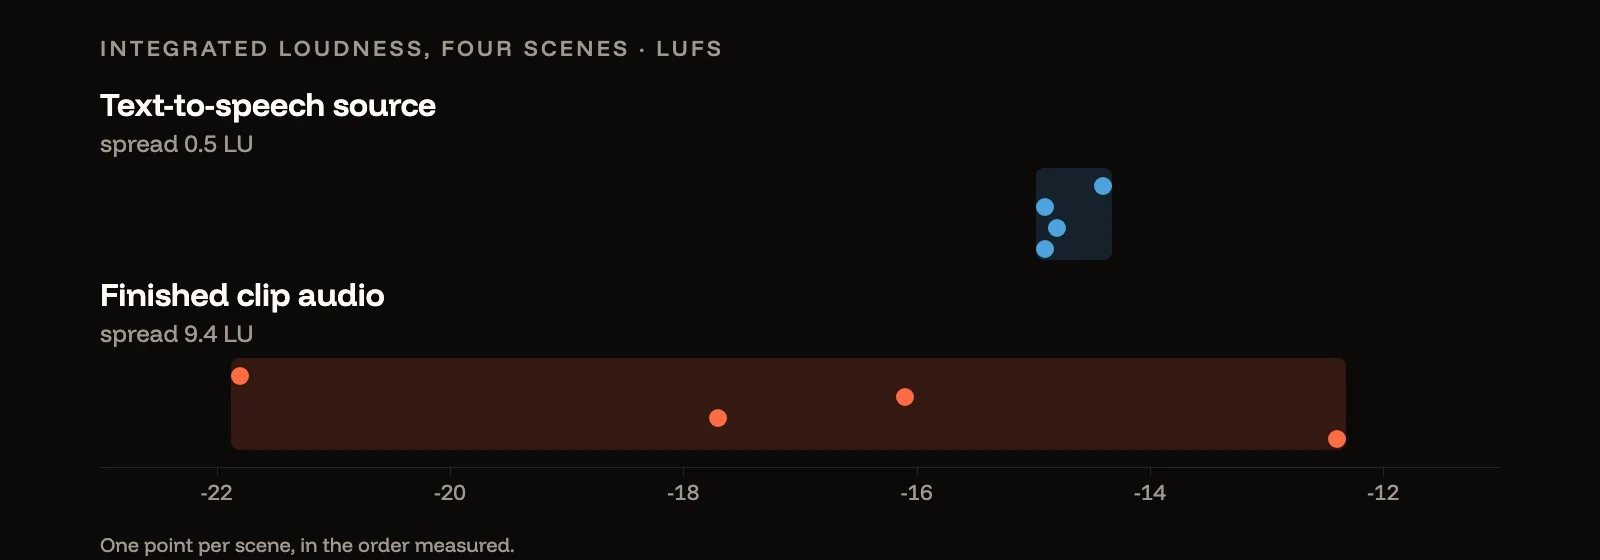
Синтез речи был почти идеальным: четыре сцены на уровне −14.4, −14.9, −14.8 и −14.9 LUFS. Видеомодель выдала −21.8, −16.1, −17.7 и −12.4. Этот перепад в девять с половиной децибел и есть то, что на самом деле скрывается за фразой «в каждом клипе она звучит по-разному».
Обратите внимание на две строки, где всё наоборот. Высота тона и фоновый шум комнаты стали более стабильными после обработки видеомоделью, чем до неё. То, что, как мы предполагали, «плавало», на самом деле оставалось совершенно стабильным.
Видеомодель использует вашу озвучку или генерирует её заново?
Одни модели используют её. Другие пропевают её заново. Именно это открытие изменило наш пайплайн. Мы провели кросс-корреляцию исходного аудио с аудио, встроенным в каждый готовый клип, а затем проверили, сохраняется ли синхронизация.
| Модель | Корреляция с исходником | Рассинхрон в клипе |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 возвращает вашу звуковую волну, сдвинутую на фиксированную задержку. Seedance 2.5 выдаёт новое исполнение: обусловленное вашим референсом, узнаваемо тот же персонаж, но пересинтезированный. По сравнению с исходником, модель понизила высоту тона на 0.2–1.3 полутона и сделала тембр глуше на 5–19 процентов, причём каждый дубль звучал по-своему.
Для модели, которая перепевает голос, вытекают два следствия, и оба они важны.
Никакой промпт это не исправит. Вариативность возникает внутри аудиосинтеза самой модели, а не в том, что можно описать словами. Мы потратили время на написание тщательных инструкций о стабильном фоновом шуме комнаты, прежде чем поняли, что фоновый шум и так был стабильным.
Вы не сможете просто подставить чистое аудио обратно. Это кажется идеальным решением — оставить хорошую картинку, а снизу подложить вашу безупречную голосовую дорожку — но на Seedance это не сработает, потому что губы синхронизированы с собственным пересчитанным по таймингу исполнением модели, которое к концу клипа уходит от вашего файла на целых 440 ms.
Какую модель выбрать для говорящей ведущей?
Определите, что именно должно сохраниться после генерации.
- Должен сохраниться точный аудиофайл голоса — клонированный голос бренда, сценарий, который должен быть зачитан слово в слово, или озвучка, уже одобренная клиентом. Используйте Wan 3.0. Её вывод жёстко привязан к вашему файлу с фиксированным смещением, так что вы можете убрать задержку и подложить оригинальную дорожку обратно под картинку. Аудиореференсы ограничены 15 секундами суммарно на один запрос, поэтому планируйте разговорные биты кусками такой длины.
- Исполнение может меняться — собственное прочтение модели вас устраивает, и сам кадр для вас важнее точной звуковой волны. Seedance 2.5 вполне подойдёт, а остаток этой статьи посвящён тому, как сделать так, чтобы её дубли звучали согласованно.
В любом случае, сам голос создаётся в генераторе синтеза речи; стабильный исходник — это как раз та часть, с которой никогда и не было проблем.
Почему на общих планах ИИ-ведущая звучит так, будто находится далеко?
Модель подстраивает акустику помещения под кадр. Ощущение «студии для подкастов против кухни» идёт именно от помещения, поэтому мы измерили соотношение прямого и отражённого звука — насколько сухим и близким кажется голос по сравнению с объёмом пространства вокруг него — а также время затухания после каждой фразы.
| Сцена | Композиция | Сухость | Затухание комнаты |
|---|---|---|---|
| Момент откровения | Крупный план | 2.8 | 116 ms |
| Представление | Крупный план | 3.1 | 81 ms |
| Начало | Общий план | 1.3 | 139 ms |
| Финал | Общий план | 0.3 | 209 ms |
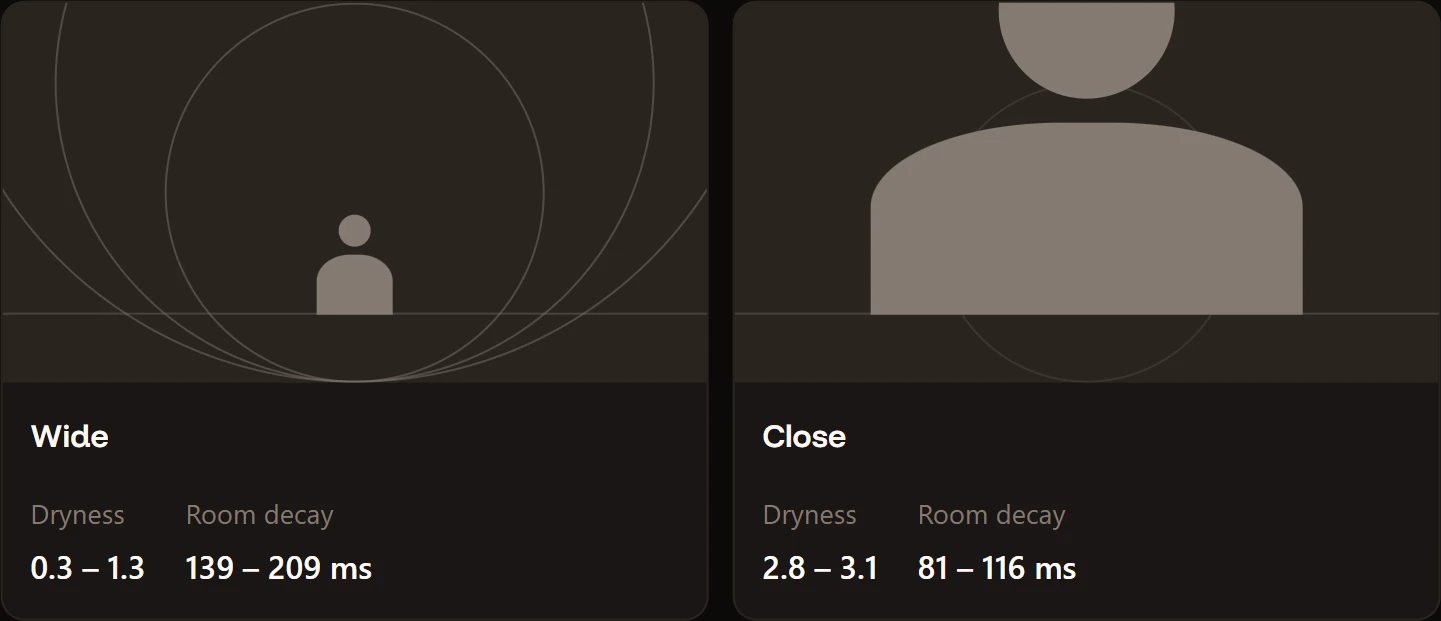
Общие планы — это планы с объёмным звуком; оба крупных плана звучат сухо и интимно. Модель выводит акустику из размера кадра: человек, снятый с другого конца комнаты, должен звучать дальше, поэтому она и отдаляет его. Это хороший киношный инстинкт. Но он остаётся незаметным до тех пор, пока вы не склеите общий план с крупным, и ваша ведущая не начнёт буквально телепортироваться.
Можно ли исправить неоднородный звук ИИ-видео на постобработке?
Две трети. Мы собрали цепочку согласования и честно всё измерили.
| До | После | |
|---|---|---|
| Разброс громкости | 9.4 LU | 0.4 LU |
| Разброс тембра | 2.9 dB | 1.1 dB |
| Разброс помещения | 2.3 dB | без изменений |
Двухпроходная нормализация громкости до единого целевого значения полностью устраняет проблему с громкостью. Это ничего не стоит, и вам следует делать это в любом случае. Измерьте каждый клип, затем скорректируйте его по полученным цифрам, используя одну цель для всех клипов в монтаже:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
Мягкий полочный эквалайзер для каждого клипа почти полностью выравнивает тембр.
Реверберация — это то, что не поддаётся коррекции. Мы добавили небольшое общее помещение к каждому клипу, чтобы у них был единый хвост, но это только ухудшило разброс, с 2.3 dB до 2.9 dB: общая реверберация добавляется к существующему хвосту каждого клипа, а не заменяет его. Согласование реверберации работает только в сторону уменьшения, путём её удаления, и для этого нужен специализированный инструмент подавления реверберации, а не просто цепочка фильтров.
Так что честный ответ на вопрос «можно ли это исправить на постобработке» таков: две трети — да, и бесплатно. Последнюю треть дешевле избежать, чем исправлять.
Как сохранить голос ИИ-ведущей единообразным во всех клипах?
Дисциплина кадрирования, а не звук. Держите все разговорные сцены на одном расстоянии съёмки, и характер помещения перестанет меняться, потому что модели больше не придётся его менять.
Мы пришли к тому же выводу, но с другой стороны. Прогнав каждый клип через модель понимания видео в качестве контроля качества, мы получили, что крупные планы набрали 7 из 10 за синхронизацию губ с нулевым смещением; общие планы набрали от 4 до 6 со смещением от 40 до 100 ms. Её объяснение: при общем плане лицо маленькое, поэтому движения губ выглядят как каша.
Два независимых измерения, один ответ: снимайте свою сгенерированную ведущую крупным планом и держите её там. Используйте общие планы для движения, для показа помещения, для всего, где она не говорит. Если вам нужна ещё более стабильная акустика, опишите её, а не позволяйте модели додумывать. Теперь каждый промпт запрашивает голос, звучащий близко и сухо по отношению к микрофону, как будто это петличка на расстоянии ладони, без эха помещения.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
Как автоматически проверить синхронизацию губ ИИ?
Пусть модель оценит это за вас. Современные модели понимания видео — любая текущая мультимодальная модель, принимающая видео — просмотрят клип и оценят синхронизацию губ, что превращает субъективный спор в чек-лист. Наша модель обнаружила губно-губную согласную, которая не до конца смыкалась, отражение в зеркале на фоне, которое не анимировалось вместе с передним планом, и незапрошенное подмигивание, которое модель добавила по собственной инициативе. Она также оценила смещение аудио в миллисекундах, а это именно та цифра, которая нужна для выбора между двумя путями. О том, как вообще работают модели синхронизации губ, см. принципы работы технологии ИИ-синхронизации губ.
Одно предостережение: выбор модели важнее, чем можно было бы ожидать. Более старая модель оценила каждый клип одинаково на 6 из 10 и отказалась оценивать какое-либо смещение — бесполезно для ранжирования. Более новая чётко разделила их и выдала смещения. Если ваш фильтр говорит, что всё одинаково, сомневайтесь в фильтре.
Когда фильтр отмечает одну плохую деталь в остальном хорошем дубле, отредактируйте клип вместо того, чтобы перегенерировать его.
Краткая версия
- Измеряйте перед тем, как перегенерировать. Разброс между сценами указывает на проблемный этап в одной таблице.
- Ваш синтез речи, скорее всего, не виноват.
- Некоторые видеомодели пропускают ваше аудио насквозь; некоторые перепевают его. Seedance 2.5 перепевает; Wan 3.0 пропустила наше насквозь. Это определяет, сможете ли вы вообще вернуть чистую дорожку обратно.
- Нормализация громкости бесплатна и решает самую большую проблему.
- Реверберацию нельзя исправить, добавив ещё больше реверберации. Мы проверяли.
- Снимайте разговорные сцены крупным планом и сохраняйте расстояние постоянным. Это исправляет и акустику, и синхронизацию губ за один раз.
Каждое число на этой странице было измерено на наших собственных дублях, сгенерированных с помощью Popcraft. На обложке показаны графики громкости из первой таблицы. Метод: питч через pYIN на вокализованных фреймах, громкость через измеритель EBU R128, сухость как отношение первых 50 ms каждого начала речи к последующим 150 ms, затухание как время падения на 20 dB после окончания речи.