สรุปสั้นๆ หากเสียงพิธีกร AI ของคุณเปลี่ยนไปในแต่ละคลิป ปัญหาน่าจะไม่อยู่ที่ text-to-speech แต่อยู่ที่โมเดลวิดีโอ Seedance 2.5 จะสร้างเสียงพากย์ของคุณใหม่ในทุกเทค และเลือกสภาพเสียงห้องจากขนาดช็อต ปรับมาตรฐานความดังไปยังเป้าหมายเดียว รักษาระยะช็อตของการพูดให้เท่ากันทุกครั้ง และเมื่อจำเป็นต้องรักษาไฟล์เสียงต้นฉบับไว้ ให้สร้างด้วย Wan 3.0 ซึ่งส่งผ่านเสียงของเราไปโดยไม่มีการเปลี่ยนแปลง
เราวัดค่า 5 อย่างใน 4 ฉากของวิดีโอสอนที่มีพิธีกรที่สร้างขึ้น และพบว่าระบบ text-to-speech ไม่ได้เป็นต้นเหตุของปัญหา
ผู้หญิงหนึ่งคน ห้องหนึ่งห้อง เสียงหนึ่งเสียง ฟุตเทจความยาวสิบสองนาที ทุกคลิปดูดีเมื่อดูแยกกัน แต่เมื่อนำมาตัดต่อรวมกันเธอก็เสียความสม่ำเสมอ: เสียงสดใสและใกล้ในช็อตหนึ่ง กลับฟังดูอู้อี้และห่างไกลในช็อตถัดไป ราวกับว่าเธอเดินสลับไปมาระหว่างบูธอัดพอดแคสต์กับครัวของใครบางคนกลางประโยค
ทำไมพิธีกร AI ถึงฟังดูต่างไปในทุกคลิป?
เลิกเดากันก่อน การสุ่มสร้างเทคใหม่จนกว่าจะฟังดูดีนั้นเสียค่าใช้จ่ายและไม่ได้บอกอะไรคุณเลย เราจึงวัดค่า 5 อย่างเดียวกันจากต้นฉบับ text-to-speech และจากเสียงที่เสร็จแล้ว ใน 4 ฉาก: ระดับเสียง ความสว่างของสเปกตรัม ความดังแบบ integrated ระดับเสียงรบกวน และระดับเสียงพูด ตารางเดียวก็บอกเรื่องราวทั้งหมดแล้ว
| ช่วงความแตกต่างระหว่างฉาก | ต้นฉบับ Text-to-Speech | เสียงคลิปที่เสร็จสมบูรณ์ |
|---|---|---|
| ความดัง | 0.5 LU | 9.4 LU |
| ระดับเสียงพูด | 2.5 dB | 8.3 dB |
| ระดับเสียง (ค่ามัธยฐาน F0) | 17.3 Hz | 9.5 Hz |
| เสียงห้อง (Noise floor) | 10.6 dB | 4.8 dB |
ช่วงความแตกต่าง = ตั้งแต่ฉากที่ดังที่สุดไปจนถึงเบาที่สุด ระดับเสียงสูงที่สุดไปจนถึงต่ำที่สุด
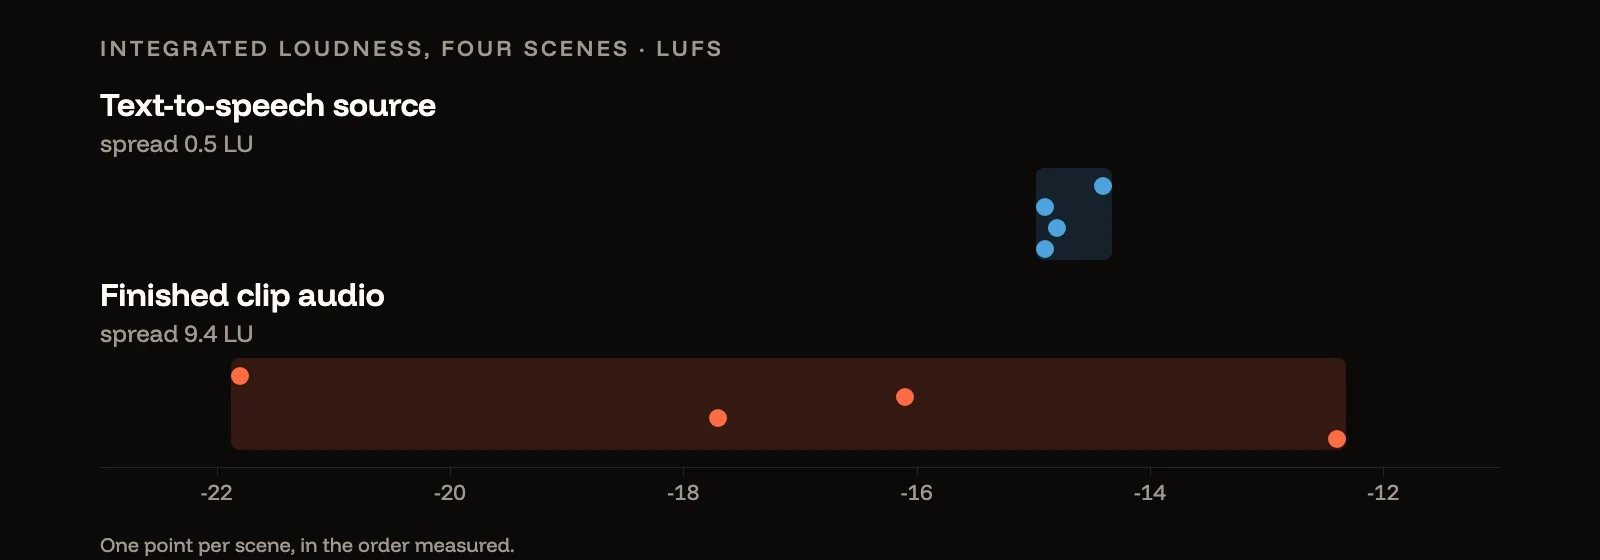
Text-to-Speech ทำได้เกือบสมบูรณ์แบบ: สี่ฉากอยู่ที่ −14.4, −14.9, −14.8 และ −14.9 LUFS โมเดลวิดีโอให้ค่ากลับมาที่ −21.8, −16.1, −17.7 และ −12.4 ช่วงความแตกต่าง 9.5 เดซิเบลนี้คือสิ่งที่ทำให้ "เธอเสียงเปลี่ยนไปในทุกคัต" อย่างแท้จริง
สังเกตสองแถวที่มีแนวโน้มตรงกันข้าม ระดับเสียงและเสียงห้องมีความสม่ำเสมอมากกว่าหลังจากผ่านโมเดลวิดีโอ สิ่งที่เราคาดเดาว่ามีการเบี่ยงเบนนั้นกลับไม่มีการเบี่ยงเบนเลย
โมเดลวิดีโอใช้เสียงพากย์ของคุณหรือสร้างเสียงใหม่?
บางโมเดลใช้เสียงเดิม บางโมเดลสร้างเสียงใหม่ นี่เป็นข้อค้นพบที่เปลี่ยนกระบวนการทำงานของเรา เราได้ทำการหาค่าสหสัมพันธ์ข้ามระหว่างเสียงต้นฉบับกับเสียงที่ฝังอยู่ในแต่ละคลิปที่เสร็จสมบูรณ์ จากนั้นตรวจสอบว่าความสอดคล้องยังคงอยู่หรือไม่
| โมเดล | ความสัมพันธ์กับต้นฉบับ | การเบี่ยงเบนตลอดคลิป |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 ส่งคืนคลื่นเสียงของคุณกลับมาโดยมีค่าความล่าช้าคงที่ Seedance 2.5 ส่งคืนการแสดงใหม่: โดยอ้างอิงจากต้นฉบับของคุณ ซึ่งเป็นตัวละครเดียวกันอย่างเห็นได้ชัด แต่ถูกสังเคราะห์ใหม่ เมื่อวัดเทียบกับต้นฉบับ มันดึงระดับเสียงลง 0.2 ถึง 1.3 เซมิโทน และทำให้โทนเสียงทุ้มลง 5 ถึง 19 เปอร์เซ็นต์ ซึ่งแตกต่างกันไปในทุกเทค
สำหรับโมเดลที่สร้างเสียงใหม่ มีผลลัพธ์ตามมาสองประการ และทั้งสองประการล้วนสำคัญ
ไม่มีพรอมต์ใดจะแก้ไขได้ ความแปรปรวนเกิดขึ้นภายในกระบวนการสังเคราะห์เสียงของโมเดล ไม่ใช่ในสิ่งที่คุณสามารถอธิบายได้ เราใช้เวลาเขียนคำแนะนำอย่างละเอียดเกี่ยวกับเสียงห้องที่สม่ำเสมอก่อนจะตระหนักว่าเสียงห้องนั้นสม่ำเสมอดีอยู่แล้ว
คุณไม่สามารถสลับเสียงที่สะอาดกลับเข้าไปได้อีก มันดูเหมือนจะเป็นวิธีแก้ไขที่สมบูรณ์แบบ คือเก็บภาพที่ดีไว้ แล้ววางแทร็กเสียงที่สมบูรณ์ของคุณไว้ด้านล่าง แต่ใน Seedance มันล้มเหลว เพราะการขยับปากกำลังติดตามการแสดงของโมเดลเองที่ถูกปรับเวลาใหม่ ซึ่งเบี่ยงเบนไปจากไฟล์ของคุณสูงสุดถึง 440 ms เมื่อสิ้นสุดคลิป
ควรใช้โมเดลใดสำหรับผู้ดำเนินรายการที่พูด?
ตัดสินใจว่าสิ่งใดที่ต้องคงอยู่หลังการสร้าง
- ไฟล์เสียงที่แน่นอนต้องคงอยู่ — เสียงแบรนด์ที่โคลนมา สคริปต์ที่ต้องพูดถูกต้องทุกคำ หรือเสียงพากย์ที่ลูกค้าอนุมัติแล้ว ใช้ Wan 3.0 เอาต์พุตของมันจะล็อกกับไฟล์ของคุณที่ค่าออฟเซ็ตคงที่ ดังนั้นคุณสามารถลบความล่าช้าและวางแทร็กต้นฉบับกลับไว้ใต้ภาพได้ การอ้างอิงเสียงจำกัดที่ 15 วินาทีต่อคำขอ ดังนั้นให้วางแผนจังหวะการพูดเป็นส่วนๆ ในความยาวดังกล่าว
- การแสดงสามารถเปลี่ยนแปลงได้ — การอ่านของโมเดลเองนั้นยอมรับได้ และคุณให้ความสำคัญกับภาพมากกว่าคลื่นเสียงที่แน่นอน Seedance 2.5 ก็ใช้ได้ และส่วนที่เหลือของโพสต์นี้จะอธิบายวิธีทำให้เทคของมันสอดคล้องกัน
ไม่ว่าจะด้วยวิธีใด เสียงเองก็เริ่มต้นที่ ตัวสร้าง Text-to-Speech แหล่งที่มาที่สม่ำเสมอคือส่วนเดียวที่ไม่เคยเป็นปัญหา
ทำไมผู้ดำเนินรายการ AI ถึงฟังดูห่างไกลในภาพกว้าง?
โมเดลปรับเสียงห้องให้เข้ากับภาพ ความรู้สึกแบบห้องบันทึกพอดแคสต์เทียบกับห้องครัวนั้นมาจากเสียงห้อง เราจึงวัดอัตราส่วนเสียงตรงต่อเสียงก้อง คือเสียงที่แห้งและใกล้เพียงใดเทียบกับปริมาณเสียงห้องรอบๆ และเวลาการสลายตัวหลังแต่ละประโยค
| ฉาก | การจัดองค์ประกอบ | ความแห้ง | การสลายตัวของห้อง |
|---|---|---|---|
| จังหวะสารภาพ | ใกล้ | 2.8 | 116 ms |
| การแนะนำ | ใกล้ | 3.1 | 81 ms |
| การเปิด | กว้าง | 1.3 | 139 ms |
| การปิด | กว้าง | 0.3 | 209 ms |
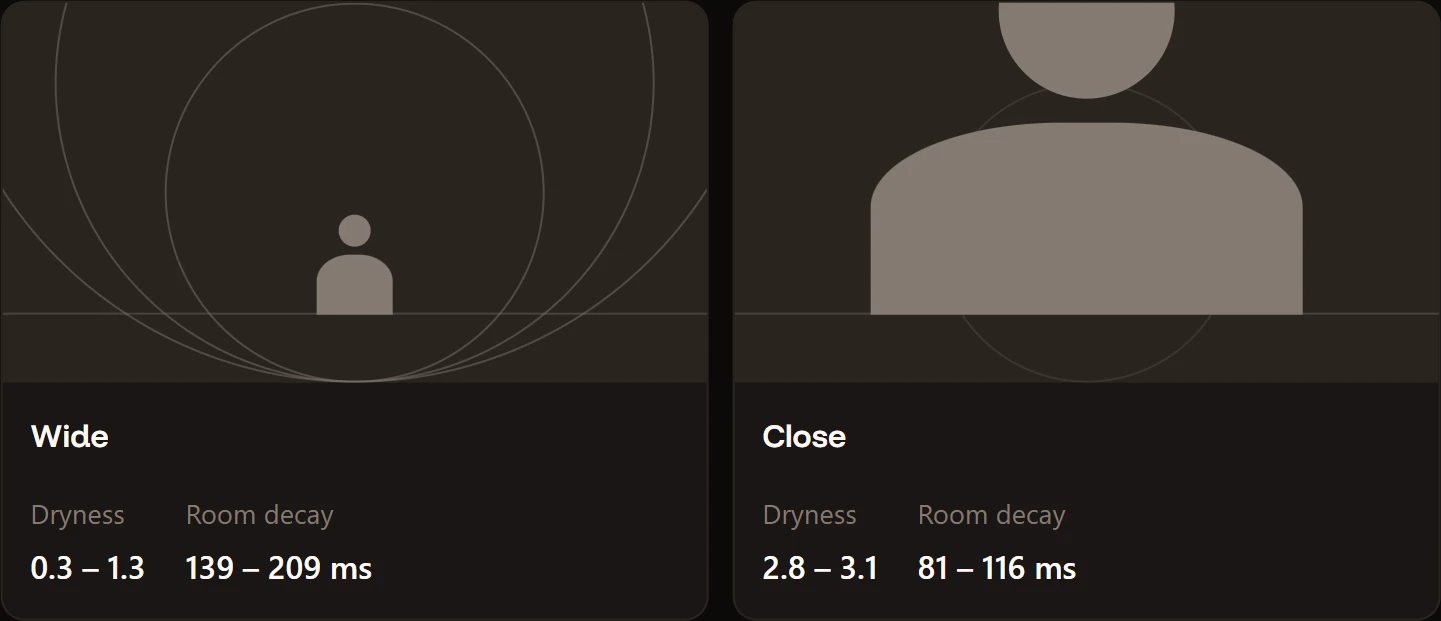
ภาพกว้างคือภาพที่มีเสียงก้อง ภาพใกล้ทั้งสองเป็นเสียงแห้งและใกล้ชิด โมเดลอนุมานสภาพเสียงจากขนาดภาพ คือคนที่ถ่ายจากอีกฟากของห้องควรจะฟังดูห่างไกลกว่า มันจึงทำให้พวกเขาอยู่ห่างออกไป นั่นเป็นสัญชาตญาณการสร้างภาพยนตร์ที่ดี แต่มันก็มองไม่เห็นจนกว่าคุณจะตัดภาพกว้างต่อกับภาพใกล้ แล้วผู้ดำเนินรายการของคุณก็ดูเหมือนจะวาร์ป
คุณสามารถแก้ไขเสียงวิดีโอ AI ที่ไม่สม่ำเสมอในขั้นตอนหลังการผลิตได้หรือไม่
แก้ไขได้สองในสามส่วน เราสร้างกระบวนการจับคู่และวัดผลอย่างตรงไปตรงมา
| ก่อน | หลัง | |
|---|---|---|
| ความแปรปรวนของความดัง | 9.4 LU | 0.4 LU |
| ความแปรปรวนของน้ำเสียง | 2.9 dB | 1.1 dB |
| ความแปรปรวนของเสียงห้อง | 2.3 dB | ไม่เปลี่ยนแปลง |
การปรับระดับความดังแบบสองรอบไปยังเป้าหมายเดียวจะขจัดปัญหาความดังออกไปได้อย่างสมบูรณ์ วิธีนี้ไม่มีค่าใช้จ่ายและคุณควรทำอยู่แล้ว วัดระดับแต่ละคลิป จากนั้นแก้ไขด้วยค่าที่ได้จากการวัด โดยใช้เป้าหมายเดียวกันสำหรับทุกคลิปในการตัดต่อ:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
การใช้ Shelf EQ แบบเบาๆ กับแต่ละคลิปจะช่วยปรับน้ำเสียงให้ใกล้เคียงกันได้อย่างมาก
เสียงก้องเป็นเพียงสิ่งที่ไม่ยอมลดลง เราเพิ่มเสียงห้องขนาดเล็กที่ใช้ร่วมกันให้กับทุกคลิปเพื่อให้มีหางเสียงเดียวกัน แต่กลับทำให้ความแปรปรวน แย่ลง จาก 2.3 dB เป็น 2.9 dB: เสียงก้องที่ใช้ร่วมกันจะไปเพิ่มหางเสียงเดิมของแต่ละคลิปแทนที่จะทดแทนมัน การจับคู่เสียงก้องจะได้ผลเฉพาะเมื่อลดลงโดยการกำจัดมันออก ซึ่งต้องใช้เครื่องมือกำจัดเสียงก้องโดยเฉพาะแทนที่จะเป็นชุดฟิลเตอร์
ดังนั้นคำตอบที่ตรงไปตรงมาสำหรับคำถามที่ว่า "แก้ไขในขั้นตอนหลังการผลิตได้ไหม" คือ: แก้ไขได้สองในสามส่วน และไม่เสียค่าใช้จ่าย ส่วนหนึ่งในสามที่เหลือการป้องกันถูกกว่าการแก้ไข
คุณจะรักษาความสม่ำเสมอของเสียงพิธีกร AI ในแต่ละคลิปได้อย่างไร
การจัดองค์ประกอบภาพอย่างมีวินัย ไม่ใช่เสียง รักษาระยะภาพของการพูดทุกจังหวะให้เท่าเดิม แล้วลักษณะเสียงห้องจะไม่เปลี่ยน เพราะโมเดลจะไม่ถูกขอให้เปลี่ยนมัน
เราพบข้อสรุปเดียวกันจากอีกทิศทางหนึ่ง การนำทุกคลิปผ่านโมเดลทำความเข้าใจวิดีโอเพื่อตรวจสอบคุณภาพ ภาพระยะใกล้ได้คะแนนความตรงกับปาก 7 จาก 10 โดยไม่มีความคลาดเคลื่อน ภาพระยะไกลได้คะแนน 4 ถึง 6 โดยมีความคลาดเคลื่อน 40 ถึง 100 ms คำอธิบายคือ: ในภาพระยะไกลใบหน้าจะเล็ก ทำให้รูปปากดูเบลอ
การวัดผลอิสระสองวิธีให้คำตอบเดียวกัน: ถ่ายพิธีกรที่สร้างขึ้นของคุณในระยะใกล้ และรักษาระยะนั้นไว้ ใช้ภาพระยะไกลสำหรับการเคลื่อนไหว สำหรับห้อง หรือสำหรับทุกสิ่งที่เธอไม่ได้พูด หากคุณต้องการให้เสียงนิ่งยิ่งขึ้นไปอีก ให้ระบุในพรอมต์แทนที่จะปล่อยให้โมเดลคาดเดาเอง ทุกพรอมต์ตอนนี้จะระบุให้เสียงอยู่ใกล้และแห้งสนิทกับไมโครโฟน ราวกับใช้ไมค์หนีบปกเสื้อที่ห่างออกไปหนึ่งช่วงมือ โดยไม่มีเสียงก้องจากห้อง
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
คุณจะตรวจสอบความตรงกับปากของ AI โดยอัตโนมัติได้อย่างไร
ให้โมเดลประเมินแทนคุณ โมเดลทำความเข้าใจวิดีโอสมัยใหม่ ซึ่งเป็นโมเดลมัลติโมดัลปัจจุบันที่รองรับวิดีโอ จะดูคลิปและประเมินความตรงกับปาก ซึ่งเปลี่ยนข้อโต้แย้งเชิงอัตวิสัยให้เป็นเช็กลิสต์ โมเดลของเราตรวจพบพยัญชนะริมฝีปากที่ปิดไม่สนิท ภาพสะท้อนในกระจกพื้นหลังที่ไม่ได้ขยับตามฉากหน้า และการขยิบตาที่ไม่ได้สั่งให้ทำซึ่งโมเดลเพิ่มเข้ามาเอง นอกจากนี้ยังประเมินความคลาดเคลื่อนของเสียงเป็นมิลลิวินาที ซึ่งเป็นตัวเลขที่คุณต้องใช้เพื่อเลือกระหว่างสองวิธี สำหรับการทำงานของโมเดลตรวจสอบความตรงกับปากตั้งแต่แรก ดูที่ อธิบายเทคโนโลยี AI lip sync
ข้อควรระวังหนึ่งข้อ: การเลือกโมเดลสำคัญกว่าที่คุณคิด โมเดลรุ่นเก่าให้คะแนนทุกคลิปเท่ากันที่ 6 จาก 10 และปฏิเสธที่จะประเมินความคลาดเคลื่อน ซึ่งไร้ประโยชน์สำหรับการจัดอันดับ โมเดลรุ่นใหม่แยกแยะได้อย่างชัดเจนและให้ค่าความคลาดเคลื่อนมา หากตัวตรวจสอบของคุณบอกว่าทุกอย่างเหมือนกัน ให้สงสัยตัวตรวจสอบไว้ก่อน
เมื่อตัวตรวจสอบพบจุดบกพร่องหนึ่งจุดในเทคที่ดีอยู่แล้ว ให้แก้ไขคลิปแทนการสร้างใหม่
สรุปสั้นๆ
- วัดผลก่อนสร้างใหม่ ความแปรปรวนระหว่างฉากจะระบุขั้นตอนที่มีปัญหาในตารางเดียว
- ข้อความที่แปลงเป็นเสียงของคุณน่าจะไม่ได้เป็นต้นเหตุ
- โมเดลวิดีโอบางตัวส่งผ่านเสียงของคุณไปเลย บางตัวสร้างเสียงใหม่ Seedance 2.5 สร้างเสียงใหม่ Wan 3.0 ส่งผ่านเสียงของเราไปเลย สิ่งนี้กำหนดว่าคุณจะสามารถสลับแทร็กเสียงที่สะอาดกลับเข้าไปได้อีกหรือไม่
- การปรับระดับความดังทำได้ฟรีและแก้ปัญหาที่ใหญ่ที่สุดได้
- เสียงก้องไม่สามารถแก้ไขได้ด้วยการเพิ่มเสียงก้องเข้าไปอีก เราทดสอบแล้ว
- ถ่ายจังหวะการพูดในระยะใกล้และรักษาระยะให้คงที่ มันแก้ไขทั้งเสียงแวดล้อมและความตรงกับปากไปพร้อมกัน
ทุกตัวเลขในหน้านี้วัดจากเทคของเราเอง ซึ่งสร้างด้วย Popcraft ภาพปกแสดงกราฟตัวเลขความดังในตารางแรก วิธีการ: ระดับเสียงผ่าน pYIN บนเฟรมที่มีเสียง ความดังผ่านมิเตอร์ EBU R128 ความแห้งเป็นอัตราส่วนของ 50 ms แรกของการเริ่มพูดแต่ละครั้งต่อ 150 ms ถัดไป การลดลงเป็นเวลาที่ลดลง 20 dB หลังจากหยุดพูด