NEWสร้าง โมเดล 3D จากข้อความหรือรูปภาพ — พร้อมริกกิ้ง แอนิเมชัน และส่งออกไฟล์ลองใช้ 3D
PopcraftPopcraft
โมเดลเสียงโดย ElevenLabs

Eleven v4 + Eleven v4 Turboไม่ได้แค่อ่านบทพูด
แต่สวมบทบาทนั้น

ElevenLabs ขนานนาม Eleven v4 ว่าเป็น "โมเดลแปลงข้อความเป็นเสียงที่สื่ออารมณ์ได้ดีที่สุดของเรา" กำหนดรูปแบบการพูดในบทด้วยแท็กอินไลน์ รองรับมากกว่า 90 ภาษา และยาวได้ถึง 10,000 ตัวอักษรต่อเทค และ v4 Turbo ก็ตอบสนองเร็วพอที่จะสนทนาได้แบบเรียลไทม์

[whispers] Don't move. It's right behind you.Eleven v4TTSสร้าง
90+ ภาษา10,000 ตัวอักษรต่อเทคอินไลน์ แท็กเสียง
นักพากย์หญิงที่ไมโครโฟนคอนเดนเซอร์ในบูธอัดเสียงแสงสลัว ส่องสว่างด้วยโคมไฟโทนอบอุ่น
การให้เสียงตัวละคร
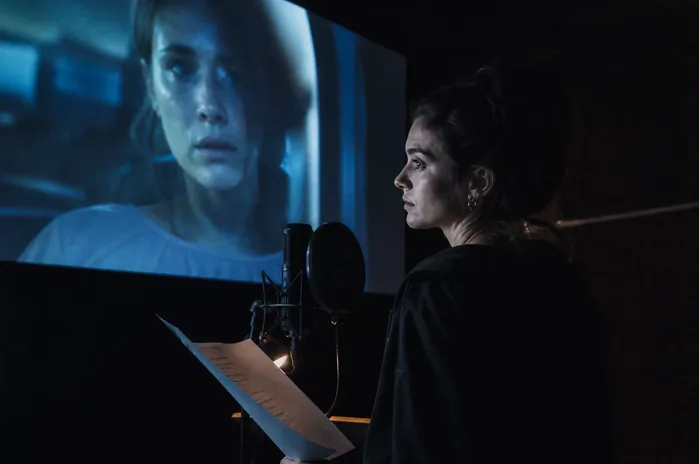
เวทีพากย์เสียง: นักแสดงหญิงกำลังดูฉากที่ฉายบนจอ ใบหน้าของเธอถูกส่องสว่างด้วยแสงจากหน้าจอ
การพากย์เสียง
ห้องควบคุมยามค่ำคืน คลื่นเสียงเรืองแสงบนหน้าจอตรงหน้าวิศวกร
การกำกับ
ตัวละครในเกม: อัศวินสวมเกราะภายใต้แสงไฟ กำลังพูดกลางประโยค
NPC ในเกม
พนักงานสนับสนุนกำลังสวมเฮดเซ็ตพูดคุยในสำนักงานยามรุ่งสาง
ตัวแทนเสียง
ผู้บรรยายผมสีเงินกำลังอ่านออกเสียงจากหนังสือปกแข็งบนเก้าอี้นวมภายใต้แสงโคมไฟ
หนังสือเสียง

ลองฟังดู สคริปต์อยู่ข้างๆ ทุกคลิป

8 เทก สร้างขึ้นใน Popcraft คำในวงเล็บสีส้มคือคำสั่งกำกับทั้งหมด: ไม่มีการตัดต่อ ไม่มีการนำเทกมาต่อกัน และไม่มีอะไรในเสียงที่ไม่ได้อยู่ในสคริปต์

01

หนึ่งประโยค ห้าสไตล์การพูด

[warm] The lighthouse keeper left a lamp burning for ships that never came.

[low, threatening] The lighthouse keeper left a lamp burning for ships that never came.

[rushed] The lighthouse keeper left a lamp burning for ships that never came.

[a tired detective who has heard it all before] The lighthouse keeper left a lamp burning for ships that never came.

[hushed and reverent, like a nature documentary narrator] The lighthouse keeper left a lamp burning for ships that never came.

02

NPC ในเกม เปลี่ยนอารมณ์ในบทพูด

[casual] You're looking for work, eh? Hmm, I might have something for you. [door creaking] [suddenly suspicious, lowering his voice] Wait. Who sent you? [pause] [delighted] Marta's cousin! Well why didn't you say so. [coins clinking] Half now, half when it's done.

03

จังหวะเดียว สี่ภาษา

[softly] Don't be afraid. We'll cross together when the morning comes.

[softly] 怖がらないで。朝が来たら、一緒に渡ろう。ภาษาญี่ปุ่น

[softly] Não tenha medo. Vamos atravessar juntos quando a manhã chegar.โปรตุเกสแบบบราซิล

[softly] 别害怕。等天亮了,我们一起过去。จีนกลาง

เสียงเดียวกัน แท็กเดียวกัน สี่ภาษาที่ ElevenLabs ระบุว่ามีการพัฒนาขึ้นมากที่สุดใน v4

04

ตัวแทนสนับสนุนที่ฟังดูเป็นธรรมชาติ

[warm] Thanks so much for holding. I can see the duplicate charge right here. [reassuring] You don't need to do anything else; the refund goes out today. [clear, measured] And your eSIM for Reykjavik is active. Anything else I can check?

ระดับภาษาที่ v4 Turbo ถูกสร้างมาเพื่อใช้ในการโทรสด

05

เสียงกระซิบที่ยังคงเป็นเสียงกระซิบ

[whispers] Don't move. It's right behind you. [pause] [whispers] On three, we run. One. Two. [shouts] Run!

06

ฉากเปิดหนังสือเสียง

[quiet, measured narration] When I was young, I thought the mountain stood because it was strong. [pause] I know better now. [long pause] It stood because it had learned where to bend.

v4 รองรับ 10,000 อักขระในหนึ่งคำขอ ซึ่งเท่ากับเสียงความยาวประมาณสิบนาที

07

เช้าวันจันทร์

[sleepy drowsy voice] Mmm, five more minutes. [yawning] Is it really Monday already?

08

การกำกับด้วยภาษาธรรมดา

[like a sports commentator, speeding up] She takes it on the half-volley, past one, past two, she's through on goal. [amazed] Oh, that is extraordinary!

แท็กไม่จำเป็นต้องมาจากรายการ เพียงอธิบายรูปแบบการพูด โมเดลก็จะทำตาม

สองโมเดล หนึ่งสำหรับงานแสดง หนึ่งสำหรับการสนทนา

ที่ผ่านมาคุณต้องเลือกระหว่างเสียงที่สื่ออารมณ์ได้ลึกซึ้งกับเสียงที่ตอบสนองรวดเร็ว Eleven v4 ได้ยุติข้อจำกัดนี้: โมเดลมาตรฐานรองรับงานเสียงยาว และ Turbo รองรับการใช้งานสนทนาสด

สำหรับครีเอเตอร์

Eleven v4

สร้างมาเพื่อการสร้างสรรค์คอนเทนต์และเสียงรูปแบบยาว: หนังสือเสียง งานพากย์เสียงตัวละคร การบรรยายระดับยาว คุณเขียนการถ่ายทอดมาอย่างไรก็ได้แบบนั้น รวมถึงเสียงประกอบฉาก

  • 10,000อักขระต่อคำขอ สร้างเสียงยาวประมาณสิบนาทีในครั้งเดียว
  • 90+ภาษา เพิ่มขึ้นจาก 70+ ภาษาใน v3
  • แท็กอารมณ์ จังหวะ การโต้ตอบ สำเนียง และเอฟเฟกต์เสียง เขียนแทรกในบรรทัด
  • IPAการออกเสียงที่แม่นยำ เขียนระหว่างเครื่องหมายทับ
"จุดสูงสุดของการวิจัยล่าสุดของเราในการสร้างเสียงพูดที่สื่ออารมณ์"ElevenLabs, โพสต์เปิดตัว
สำหรับ Voice Agent

Eleven v4 Turbo

ความสามารถในการแสดงออกที่เท่าเดิม แต่ปรับแต่งมาเพื่อการทำงานแบบเรียลไทม์: ประมาณ ค่ามัธยฐานความหน่วงของการอนุมาน 100 ms และประมาณ เวลาจนถึงเสียงพูดแรก 150 ms, จากการวัดของ ElevenLabs

  • ~100 msค่ามัธยฐานความหน่วงของการอนุมาน
  • ~150 msค่ามัธยฐานเวลาจนถึงเสียงพูดแรก
  • สดรองรับการโทรฝ่ายสนับสนุน การขาย และการนัดหมาย ที่สามารถปรับน้ำเสียงระหว่างสนทนาได้
"เร็วกว่าช่วงหยุดเฉลี่ยระหว่างคนสองคนคุยกัน"ElevenLabs, โพสต์เปิดตัว

กำกับได้เหมือนทำงานกับนักพากย์ในสตูดิโอ

ทุกอย่างด้านล่างนี้อยู่ในสคริปต์เอง ไม่ต้องใช้ตัวเลื่อน ไม่ต้องทำโพสต์โปรดักชัน

แท็กเสียง

เขียนอารมณ์กำกับไว้ในจุดที่เกิดขึ้น

แท็กจะแทรกอยู่ในข้อความในวงเล็บเหลี่ยม และเริ่มมีผลตั้งแต่จุดที่ปรากฏไปจนถึงแท็กถัดไป มีทั้งหมด 6 ชนิด: อารมณ์ การถ่ายทอด จังหวะ ปฏิกิริยา สำเนียง และเอฟเฟกต์เสียง สามารถซ้อนคำสั่งโดยคั่นด้วยจุลภาค และโมเดลจะแสดงออกตามลำดับ

[excited] Big news, everyone. [pause] [whispers] The summer menu drops Friday. [laughs]
ภาพโคลสอัพของไมโครโฟนคอนเดนเซอร์ในแสงย้อนที่มีหมอกควัน
ภาษา

90+ ภาษาในหนึ่งเสียง

ElevenLabs ถือว่าการพูดแสดงอารมณ์ข้ามภาษาเป็นหนึ่งในความท้าทายที่ยากที่สุดของ AI ด้านเสียง v4 รองรับมากกว่า 90 ภาษา โดยมีการพัฒนาอย่างมากในภาษาญี่ปุ่น โปรตุเกสบราซิล จีนกลาง และกวางตุ้ง เสียงเดียวกันสามารถถ่ายทอดทิศทางเดียวกันได้ครบทุกภาษา การพากย์เสียงจึงคงคาแรคเตอร์เดิมไว้ได้

นักแสดงละครวิทยุ 4 คนยืนรวมกันรอบไมโครโฟนตัวเดียว
การบันทึกเสียงยาว

10,000 ตัวอักษรในหนึ่งคำขอ

เพิ่มเป็นสองเท่าจากที่ v3 รองรับ: สร้างเสียงยาวประมาณ 10 นาทีจากการเจนเพียงครั้งเดียว ไม่ว่าจะเป็นบททั้งบท สคริปต์ซัพพอร์ตเต็มรูปแบบ หรือฉากยาว ก็สามารถรักษาจังหวะการเล่าเรื่องไว้ได้ด้วยการอ่านต่อเนื่องเป็นหนึ่งเดียว แทนที่จะต้องนำมาต่อกันทีละย่อหน้า

กองกระดาษต้นฉบับวางสูงข้างไมโครโฟนในสตูดิโอภายใต้แสงไฟสีอบอุ่น
การออกเสียง

ออกเสียงให้ตรงเป๊ะด้วย IPA

ชื่อ ชื่อยา ชื่อสถานที่ ชื่อผลิตภัณฑ์: เขียนการออกเสียงเป็น IPA ระหว่างเครื่องหมายทับแล้วโมเดลจะออกเสียงตามที่คุณต้องการทุกครั้ง สำหรับคำอื่นๆ v4 ทำคะแนนการออกเสียงสูงสุดเท่าที่ Artificial Analysis เคยวัดมา

The ferry to Reykjavik /ˈreɪkjavɪk/ leaves at nine.
หน้าสคริปต์ที่มีเครื่องหมายจดบันทึกด้วยดินสอวางอยู่บนขาตั้งโน้ตเพลง
เสียงโคลน

การโคลนเสียงระดับมืออาชีพกลับมาแล้ว

v3 ไม่เคยรองรับ Professional Voice Clones แต่ v4 รองรับ ดังนั้นเสียงที่คุณสร้างและเป็นเจ้าของจึงสามารถแสดงอารมณ์ได้ด้วยชุดคำสั่งแท็กทั้งหมด โคลนที่สร้างจากโมเดลก่อนหน้าสามารถเทรนใหม่สำหรับ v4 ได้ในคลิกเดียว โดยมีการยืนยันความยินยอมจากเจ้าของเสียงเบื้องหลังทุกโคลน

เครื่องบันทึกเสียงแบบม้วนต่อม้วนที่เหมือนกันสองเครื่องวางเคียงกันในแร็คสตูดิโอ

เรื่องราวเบื้องหลัง

ทุกเจเนอเรชันของ ElevenLabs ได้เพิ่มสิ่งใหม่ๆ เข้ามา และ v4 คือรุ่นแรกที่คุณไม่ต้องเลือกสิ่งใดสิ่งหนึ่ง

  • ส.ค. 2023

    Multilingual v2

    29 ภาษา และ ElevenLabs สิ้นสุดช่วงเบต้า

  • ก.ค. 2024

    Turbo v2.5

    สร้างมาเพื่อความเร็ว

  • ธ.ค. 2024

    Flash

    ความหน่วงลดลงเหลือประมาณ 75 ms เร็ว แต่ไม่สื่ออารมณ์

  • มิ.ย. 2025

    Eleven v3 alpha

    แท็กเสียง มากกว่า 70 ภาษา และบทสนทนาได้มาถึงแล้ว สื่ออารมณ์ได้ดี แต่โพสต์เปิดตัวของ v3 เองกลับบอกให้ผู้สร้างแบบเรียลไทม์ใช้ Flash ต่อไป

  • ก.พ. 2026

    Eleven v3 เปิดให้ใช้งานทั่วไป

    ความสามารถในการสื่ออารมณ์พัฒนาเต็มที่ แต่การแลกกับความเร็วก็ยังคงอยู่

  • มิ.ย. 2026

    ตัวอย่างที่วอร์ซอ

    ในงานซัมมิทที่วอร์ซอ ElevenLabs ได้สาธิตรุ่นถัดไปโดยการกระซิบ เปลี่ยนสำเนียง และเปลี่ยนอารมณ์สดๆ บนเวที

  • 28 ก.ย. 2026

    Eleven v4 + v4 Turbo

    สถาปัตยกรรมใหม่ เปิดตัวทั้งสองทิศทางพร้อมกัน: โมเดลที่สื่ออารมณ์ได้ดีที่สุดที่ ElevenLabs เคยสร้างมา และ Turbo ที่เร็วพอสำหรับการสนทนาแบบสด

บทพิสูจน์

อิสระก่อนเสมอ: Artificial Analysis จัด arena ทดสอบการฟังแบบไม่เปิดเผยตัวตนกับโมเดลเสียงชั้นนำทุกรุ่น

Artificial Analysis, ตุลาคม 2026Eleven v4บริบท
Voice Arena ของผู้ให้บริการ#1นำหน้า Cartesia Sonic 3.6 และ Gemini 3.8 Flash TTS ส่วน Eleven v3 อยู่ที่อันดับ #17 ในตารางเดียวกัน
ความเสถียรของการออกเสียง91.7%คะแนนสูงสุดที่ Artificial Analysis เคยวัดได้จากโมเดลทั้งหมด
Controlled Voice arena#2ตามหลัง Qwen-Audio-3.1-TTS-Plus ส่วน v3 ได้คะแนนต่ำกว่าทั้งสองรุ่นมาก
ความเร็วในการสร้าง73.4 ตัวอักษร/วินาทีเทียบกับ 42.5 สำหรับ v3 วัดโดย Artificial Analysis

ในการทดสอบความชอบแบบไม่เปิดเผยตัวตนของ ElevenLabs ผู้ฟังเลือก v4 ประมาณ 75% เมื่อเทียบกับโมเดลคู่แข่ง ตัวเลขนี้เป็นของผู้พัฒนา ส่วนอันดับใน arena ด้านบนไม่ใช่ ปฏิกิริยาในวันเปิดตัว: เธรดประกาศ และ ผลลัพธ์จาก Artificial Analysis

สิ่งที่เปลี่ยนไปจาก v3

Eleven v3Eleven v4
สถาปัตยกรรมตระกูล v3ใหม่ทั้งหมด
ภาษา70+90+
ความยาวคำขอ5,000 อักขระ10,000 อักขระ
การโคลนเสียงระดับมืออาชีพไม่รองรับรองรับ
การกำกับแท็กเสียงแท็ก, คำสั่งภาษาธรรมดา, IPA
เรียลไทม์ไม่แนะนำv4 Turbo, ค่ามัธยฐานการอนุมาน ~100 ms

สคริปต์ที่คุณเขียนสำหรับ v3 สามารถรันบน v4 ได้โดยไม่ต้องแก้ไข

คำถามที่พบบ่อย

เสียงโคลนที่มีอยู่ของฉันใช้งานบน v4 ได้หรือไม่

ได้ หลังจากการเทรนใหม่ เสียงโคลนที่สร้างจากโมเดลก่อนหน้าสามารถเทรนใหม่สำหรับ v4 ได้ด้วยการคลิกเพียงครั้งเดียวในคลังเสียงของ ElevenLabs โปรดเตรียมพร้อมสำหรับความแตกต่าง: เสียงที่เทรนใหม่อาจฟังดูแตกต่างจากเวอร์ชัน v3 อย่างมาก ข้อบกพร่องในการบันทึกเสียงต้นฉบับจะถูกจำลองออกมาอย่างถูกต้องตามต้นฉบับ และเสียงที่สร้างด้วย Voice Design อาจแสดงอารมณ์ได้น้อยกว่าเสียงโคลนจากการบันทึกจริง

แท็กเสียงทำงานถูกต้องทุกครั้งหรือไม่

ไม่เสมอไป เอกสารของ ElevenLabs เองระบุว่าการทำตามแท็กนั้น "ยังไม่สมบูรณ์แบบ": บางครั้งคิวการพูดอาจถูกเรนเดอร์เป็นเอฟเฟกต์เสียงแทน คุณจะได้รับผลลัพธ์ที่น่าเชื่อถือที่สุดโดยใช้หนึ่งแท็กต่อหนึ่งประโยค วางไว้หน้าคำที่ได้รับผลกระทบ และรวมคิวหลายตัวด้วยเครื่องหมายจุลภาคในวงเล็บเดียวเมื่อต้องการใช้ซ้อนกัน

จะเกิดอะไรขึ้นเมื่อเสียงพูดภาษาที่ไม่ใช่ภาษาของตัวเอง

เสียงจะพูดด้วยสำเนียงเจ้าของภาษาของภาษานั้น ไม่ใช่สำเนียงดั้งเดิมของเสียง ElevenLabs ระบุว่านี่เป็นการออกแบบโดยเจตนา และกำลังวิจัยตัวเลือกในการคงสำเนียงเดิมไว้

v4 มีการควบคุมอะไรบ้าง

ความเสถียรและความคล้ายคลึง ไม่มีแถบเลื่อนปรับสไตล์หรือความเร็ว และไม่มี SSML การหยุดเว้นจังหวะจะเขียนเป็น [pause] และ [long pause] ในสคริปต์ และส่วนอื่นๆ คือแท็ก

v4 หรือ v4 Turbo?

v4 สำหรับทุกสิ่งที่คุณเรนเดอร์และเก็บไว้: การบรรยาย ตัวละคร และการพากย์เสียงยาวสูงสุด 10,000 ตัวอักษร v4 Turbo สำหรับทุกสิ่งที่โต้ตอบกลับ: เอเจนต์เสียงและแอปแบบอินเทอร์แอกทีฟ ซึ่งค่าความหน่วงการอนุมานมัธยฐานประมาณ 100 ms ช่วยให้บทสนทนาดำเนินไปอย่างลื่นไหล

เขียนบทการแสดง v4 จัดให้

เลือกเสียง ใส่คำสั่งกำกับในวงเล็บ แล้วฟังผลลัพธ์ในไม่กี่วินาที

เสียงทั้งหมดในหน้านี้ถูกสร้างขึ้นใน Popcraft ด้วยเสียงจาก ElevenLabs โดยแสดงสคริปต์เต็มของแต่ละคลิปไว้ข้างๆ รูปภาพสร้างขึ้นโดย AI ประโยคที่อ้างอิงเป็นของ ElevenLabs เอง จากโพสต์เปิดตัว Eleven v4 การจัดอันดับมาจาก Artificial Analysis อ่านเมื่อตุลาคม 2026

สำรวจต่อ

โมเดลที่เกี่ยวข้อง

Music V2.5
Popcraft

แต่งเพลงประกอบวิดีโอในไม่กี่วินาทีด้วย Music V2.5 บน Popcraft สร้างเพลงประกอบ AI, BGM บรรเลง และแทร็กที่เข้ากับอารมณ์ตั้งแต่ 3 ถึง 200 วินาที

ElevenLabs SFX
ElevenLabs

สร้างเสียงเอฟเฟกต์จากข้อความด้วย ElevenLabs SFX บน Popcraft คลิป 0.5–22 วินาที ปรับระดับอิทธิพลพรอมต์ได้ และเสียงคุณภาพสตูดิโอ 48 kHz

Seedance 2.5
ByteDance

Seedance 2.5 สร้างวิดีโอได้สูงสุด 30 วินาทีในครั้งเดียว พร้อมสินทรัพย์อ้างอิงสูงสุด 50 รายการ ตัดต่อวิดีโอที่ควบคุมได้ ขยายเวลาแบบความเที่ยงตรงสูง อัตราส่วนภาพตั้งแต่ 0.4 ถึง 2.5 และพรอมต์ภาษาท้องถิ่นในกว่า 10 ภาษา พร้อมใช้งานบน Popcraft

Wan 3.0
Alibaba

สร้างวิดีโอ AI ความยาว 2 ถึง 30 วินาทีในการคลิกเดียวด้วย Wan 3.0 จาก Alibaba: ความละเอียด 1080p ที่ 30 fps พร้อมบทสนทนาและดนตรี รองรับภาพสูงสุด 4 ภาพ คลิป 5 คลิป และเสียงอ้างอิง 5 เสียง เริ่มต้นเพียง 11 เครดิตต่อวินาทีบน Popcraft