Tóm tắt ngắn gọn. Nếu giọng của MC AI thay đổi từ clip này sang clip khác, vấn đề có lẽ không nằm ở hệ thống chuyển văn bản thành giọng nói — mà ở mô hình video. Seedance 2.5 tái tạo lại giọng lồng tiếng của bạn ở mỗi lần quay, và chọn âm học phòng dựa trên cỡ cảnh. Hãy chuẩn hóa độ lớn về một mục tiêu, giữ mọi nhịp thoại ở cùng một khoảng cách cảnh, và khi tệp giọng nói gốc bắt buộc phải được giữ nguyên, hãy tạo trên Wan 3.0, mô hình đã giữ nguyên âm thanh của chúng tôi.
Chúng tôi đã đo lường năm yếu tố trên bốn cảnh của một video hướng dẫn có người dẫn chương trình được tạo bởi AI, và hóa ra hệ thống chuyển văn bản thành giọng nói hoàn toàn vô tội.
Một người phụ nữ, một căn phòng, một giọng nói, mười hai phút tư liệu. Mỗi clip khi đứng riêng đều ổn. Nhưng ghép chúng lại thì mọi thứ vỡ trận: sáng và gần ở cảnh này, đục và xa ở cảnh tiếp theo, cứ như thể cô ấy đã đi lạc từ phòng thu podcast sang bếp của ai đó ngay giữa câu.
Tại sao người dẫn chương trình AI nghe khác trong mỗi clip?
Đừng đoán mò nữa. Việc quay lại nhiều lần cho đến khi nghe ổn rất tốn kém và chẳng cho bạn biết điều gì. Vì vậy, chúng tôi đã đo cùng năm yếu tố trên nguồn chuyển văn bản thành giọng nói và trên âm thanh hoàn thiện, qua bốn cảnh: cao độ, độ sáng phổ, độ lớn tích hợp, sàn nhiễu và mức lời nói. Một bảng dữ liệu đã nói lên tất cả.
| Độ chênh lệch giữa các cảnh | Nguồn chuyển văn bản thành giọng nói | Âm thanh clip hoàn thiện |
|---|---|---|
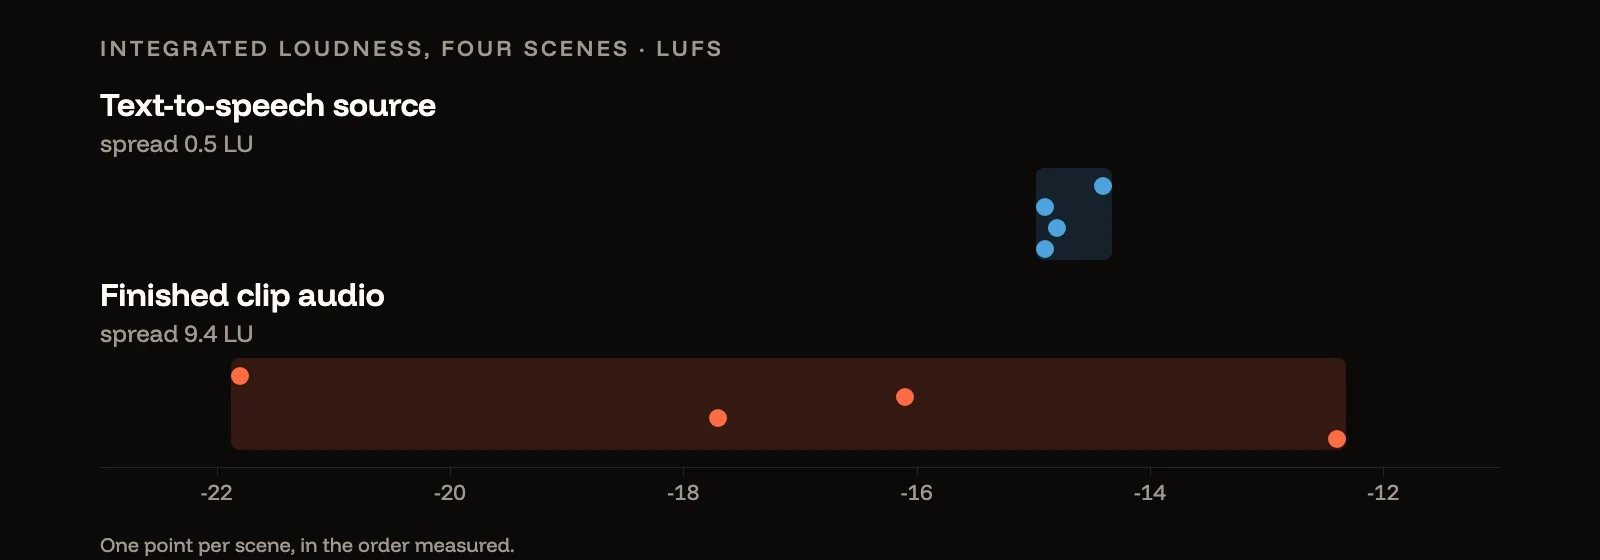
| Độ lớn | 0.5 LU | 9.4 LU |
| Mức giọng nói | 2.5 dB | 8.3 dB |
| Cao độ (F0 trung vị) | 17.3 Hz | 9.5 Hz |
| Âm nền phòng (sàn nhiễu) | 10.6 dB | 4.8 dB |
Độ chênh lệch = từ cảnh ồn nhất đến yên nhất, cao độ từ cao nhất đến thấp nhất.
Phần chuyển văn bản thành giọng nói gần như hoàn hảo: bốn cảnh ở mức −14.4, −14.9, −14.8 và −14.9 LUFS. Mô hình video trả về −21.8, −16.1, −17.7 và −12.4. Mức dao động chín decibel rưỡi đó chính là thực chất của việc "cô ấy nghe khác đi ở mỗi cú cắt".
Hãy chú ý đến hai hàng đi theo hướng ngược lại. Cao độ và âm nền phòng nhất quán hơn sau khi qua mô hình video so với trước đó. Thứ mà chúng tôi cho là đang bị lệch hóa ra lại không hề lệch chút nào.
Mô hình video sử dụng giọng đọc của bạn hay tạo lại nó?
Một số mô hình sử dụng nó. Một số mô hình "hát" lại từ đầu. Đây là phát hiện đã thay đổi quy trình của chúng tôi. Chúng tôi đã tương quan chéo âm thanh nguồn với âm thanh được nhúng trong mỗi clip hoàn thiện, sau đó kiểm tra xem sự căn chỉnh có được giữ nguyên hay không.
| Mô hình | Tương quan với nguồn | Độ lệch trên toàn clip |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 trả lại dạng sóng của bạn, bị dịch chuyển bởi một độ trễ cố định. Seedance 2.5 trả lại một màn trình diễn mới: được điều kiện hóa dựa trên tham chiếu của bạn, nhận ra rõ ràng là cùng một nhân vật, nhưng đã được tổng hợp lại. Khi đo lường so với nguồn, nó đã hạ cao độ xuống từ 0.2 đến 1.3 nửa cung và làm tối âm sắc đi từ 5 đến 19 phần trăm, khác nhau ở mỗi lần quay.
Đối với một mô hình hát lại, có hai hệ quả kéo theo, và cả hai đều quan trọng.
Không câu lệnh nào sẽ khắc phục được nó. Sự biến thiên xảy ra bên trong quá trình tổng hợp âm thanh của mô hình, không phải ở bất cứ điều gì bạn có thể mô tả. Chúng tôi đã dành thời gian viết các hướng dẫn cẩn thận về âm nền phòng nhất quán trước khi nhận ra rằng âm nền phòng vốn đã nhất quán rồi.
Bạn không thể chèn lại âm thanh sạch vào. Nó có vẻ như là một bản sửa lỗi hoàn hảo — giữ lại hình ảnh đẹp, đặt rãnh giọng nói nguyên bản của bạn xuống dưới — và trên Seedance nó thất bại, vì chuyển động môi đang bám theo màn trình diễn được căn chỉnh lại thời gian của chính mô hình, vốn đã lệch tới 440 ms so với tệp của bạn vào cuối clip.
Bạn nên sử dụng mô hình nào cho người dẫn chương trình đang nói?
Hãy quyết định xem yếu tố nào phải tồn tại qua quá trình tạo.
- Tệp giọng nói chính xác phải được giữ nguyên — một giọng thương hiệu đã nhân bản, một kịch bản phải chuẩn xác từng từ, một bản lồng tiếng mà khách hàng đã duyệt. Sử dụng Wan 3.0. Đầu ra của nó bám chặt vào tệp của bạn ở một độ lệch cố định, vì vậy bạn có thể loại bỏ độ trễ và đặt lại rãnh âm thanh gốc dưới hình ảnh. Các tham chiếu âm thanh bị giới hạn ở tổng cộng 15 giây cho mỗi yêu cầu, vì vậy hãy lên kế hoạch cho các nhịp nói theo từng đoạn có độ dài như vậy.
- Màn trình diễn có thể thay đổi — cách đọc của chính mô hình là chấp nhận được, và bạn quan tâm đến cảnh quay hơn là dạng sóng chính xác. Seedance 2.5 ổn, và phần còn lại của bài viết này là cách bạn giữ cho các lần quay của nó khớp nhau.
Dù bằng cách nào, bản thân giọng nói bắt đầu từ trình tạo chuyển văn bản thành giọng nói; một nguồn nhất quán là phần duy nhất chưa bao giờ là vấn đề.
Tại sao người dẫn chương trình AI nghe có vẻ ở xa trong các cảnh quay toàn?
Mô hình khớp âm thanh phòng với cảnh quay. Cảm giác phòng thu podcast so với nhà bếp đến từ căn phòng, vì vậy chúng tôi đã đo tỷ lệ trực tiếp trên phản xạ — giọng nói nghe khô và gần như thế nào so với lượng âm vang xung quanh nó — và thời gian suy giảm sau mỗi cụm từ.
| Cảnh | Khuôn hình | Độ khô | Suy giảm phòng |
|---|---|---|---|
| Nhịp tâm sự | Cận | 2.8 | 116 ms |
| Giới thiệu | Cận | 3.1 | 81 ms |
| Mở đầu | Toàn | 1.3 | 139 ms |
| Kết thúc | Toàn | 0.3 | 209 ms |
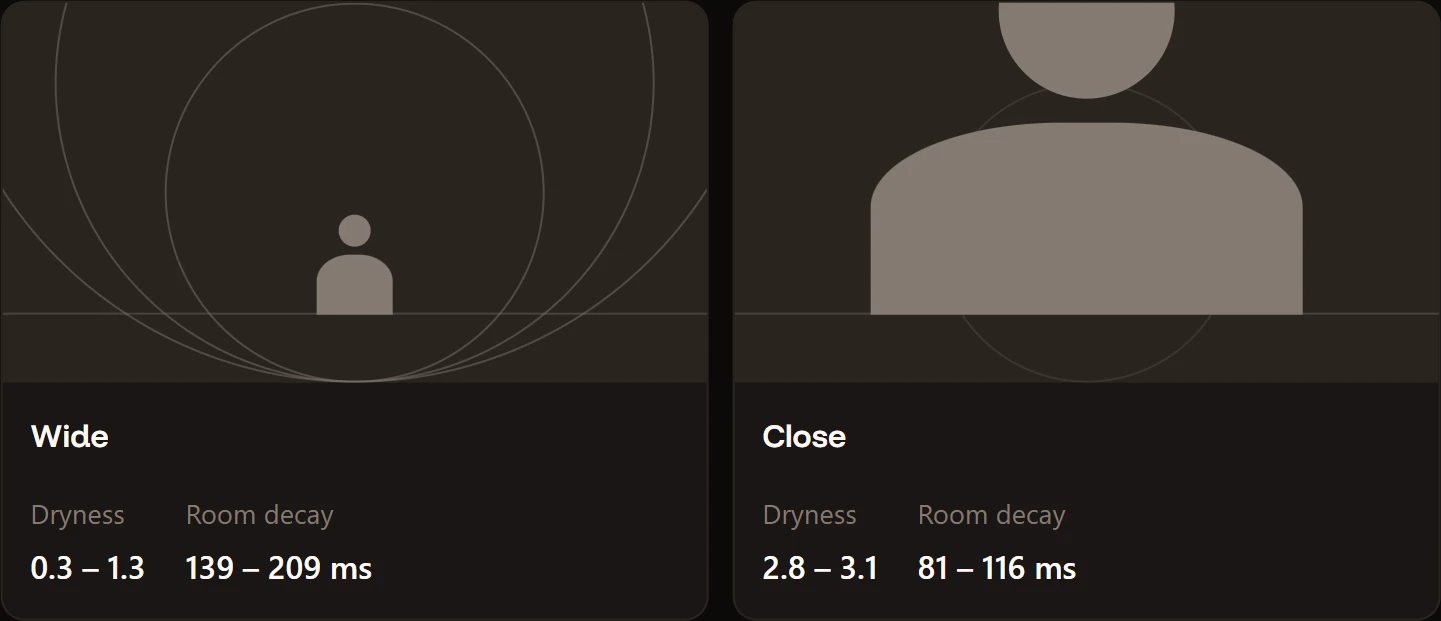
Các cảnh quay toàn là những cảnh có nhiều âm vang; cả hai cảnh cận đều khô và thân mật. Mô hình suy ra âm học từ kích thước cảnh quay — một người được quay từ phía bên kia căn phòng lẽ ra phải nghe xa hơn, vì vậy nó đặt họ ra xa hơn. Đó là bản năng làm phim tốt. Nó cũng vô hình cho đến khi bạn cắt một nhịp toàn đối diện với một nhịp cận và người dẫn chương trình của bạn có vẻ như đang dịch chuyển tức thời.
Bạn có thể khắc phục âm thanh video AI không nhất quán trong hậu kỳ không?
Được hai phần ba. Chúng tôi đã xây dựng một chuỗi khớp nối và đo lường nó một cách trung thực.
| Trước | Sau | |
|---|---|---|
| Độ chênh lệch âm lượng | 9.4 LU | 0.4 LU |
| Độ chênh lệch âm sắc | 2.9 dB | 1.1 dB |
| Độ chênh lệch âm phòng | 2.3 dB | không đổi |
Chuẩn hóa âm lượng hai lượt về một mục tiêu duy nhất sẽ loại bỏ hoàn toàn vấn đề về âm lượng. Việc này không tốn kém gì và bạn nên thực hiện nó dù thế nào đi nữa. Hãy đo lường từng đoạn video, sau đó hiệu chỉnh bằng các số liệu mà phép đo trả về, sử dụng cùng một mục tiêu cho mọi đoạn video trong bản dựng:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
Một bộ lọc EQ shelf nhẹ nhàng cho từng đoạn video sẽ đưa âm sắc về mức đồng bộ hầu như hoàn toàn.
Âm vang là yếu tố không hề suy chuyển. Chúng tôi đã thêm một âm phòng chung nhỏ vào mọi đoạn video để chúng chia sẻ cùng một phần đuôi âm, và điều đó làm độ chênh lệch tệ hơn, từ 2.3 dB lên 2.9 dB: một âm vang chung sẽ cộng thêm vào phần đuôi âm hiện có của từng đoạn video thay vì thay thế nó. Việc khớp âm vang chỉ hiệu quả khi làm giảm nó đi, và điều đó cần một công cụ khử âm vang chuyên dụng thay vì một chuỗi bộ lọc.
Vì vậy, câu trả lời trung thực cho câu hỏi "tôi có thể khắc phục nó trong hậu kỳ không" là: hai phần ba trong số đó, có, và miễn phí. Một phần ba còn lại thì việc phòng tránh sẽ rẻ hơn là sửa chữa.
Làm thế nào để giữ giọng nói của MC AI nhất quán qua các đoạn video?
Kỷ luật về bố cục hình ảnh, không phải âm thanh. Hãy giữ mọi nhịp thoại ở cùng một khoảng cách khuôn hình và đặc tính âm phòng sẽ ngừng thay đổi, bởi vì mô hình sẽ không còn bị yêu cầu phải thay đổi nó nữa.
Chúng tôi đã đạt được cùng một kết luận từ một hướng tiếp cận khác. Khi đưa mọi đoạn video qua một mô hình hiểu video như một cổng kiểm soát chất lượng, các cảnh cận đạt 7 trên 10 điểm về độ khớp môi với độ lệch bằng không; các cảnh toàn đạt 4 đến 6 điểm với độ lệch từ 40 đến 100 ms. Lời giải thích của nó: ở bố cục toàn cảnh, khuôn mặt sẽ nhỏ, nên các chuyển động miệng trông nhòe nhoẹt.
Hai phép đo độc lập, một câu trả lời: hãy quay MC được tạo của bạn ở cảnh cận, và giữ cô ấy ở đó. Sử dụng cảnh toàn cho các chuyển động, cho không gian phòng, cho bất cứ điều gì mà cô ấy không nói. Nếu bạn cần độ ổn định âm học cao hơn nữa, hãy mô tả nó thay vì để mô hình tự suy luận. Mọi câu lệnh giờ đây đều yêu cầu một giọng nói cận và khô sát micro, như thể đang dùng micro cài áo cách một gang tay, không có âm vang phòng.
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
Làm thế nào để kiểm tra độ khớp môi của AI một cách tự động?
Hãy để một mô hình chấm điểm nó cho bạn. Các mô hình hiểu video hiện đại — bất kỳ mô hình đa phương thức hiện tại nào chấp nhận đầu vào là video — sẽ xem một đoạn video và chấm điểm độ khớp môi, biến một cuộc tranh luận chủ quan thành một danh sách kiểm tra. Mô hình của chúng tôi đã phát hiện ra một phụ âm hai môi không khép kín hoàn toàn, một hình ảnh phản chiếu trong gương ở hậu cảnh không chuyển động đồng bộ với tiền cảnh, và một cái nháy mắt không được yêu cầu mà mô hình đã tự ý thêm vào. Nó cũng ước tính độ lệch âm thanh tính bằng mili giây, đây chính xác là con số bạn cần để lựa chọn giữa hai hướng xử lý. Để hiểu cách các mô hình khớp môi hoạt động ngay từ đầu, hãy xem Giải thích công nghệ khớp môi AI.
Một lưu ý: việc lựa chọn mô hình quan trọng hơn bạn tưởng. Một mô hình cũ hơn đã đánh giá mọi đoạn video giống hệt nhau ở mức 6 trên 10 và từ chối ước tính bất kỳ độ lệch nào — vô dụng cho việc xếp hạng. Một mô hình mới hơn đã phân tách chúng rõ ràng và đưa ra các độ lệch. Nếu cổng kiểm soát của bạn báo rằng mọi thứ đều giống nhau, hãy nghi ngờ chính cổng kiểm soát đó.
Khi cổng kiểm soát gắn cờ một chi tiết lỗi trong một cảnh quay vốn dĩ tốt, hãy chỉnh sửa đoạn video thay vì tạo lại nó.
Tóm tắt ngắn gọn
- Hãy đo lường trước khi bạn tạo lại. Độ chênh lệch giữa các cảnh sẽ chỉ ra giai đoạn bị lỗi chỉ trong một bảng.
- Tính năng chuyển văn bản thành giọng nói của bạn có lẽ vô tội.
- Một số mô hình video truyền nguyên âm thanh của bạn qua; một số thì tạo lại giọng. Seedance 2.5 tạo lại giọng; Wan 3.0 truyền nguyên bản của chúng tôi qua. Điều đó quyết định việc bạn có thể thay thế lại bản âm thanh sạch hay không.
- Chuẩn hóa âm lượng thì miễn phí và khắc phục được vấn đề lớn nhất.
- Âm vang không thể khắc phục bằng cách thêm nhiều âm vang hơn. Chúng tôi đã kiểm tra rồi.
- Hãy quay các nhịp thoại ở cảnh cận và giữ khoảng cách không đổi. Nó khắc phục cả âm học lẫn độ khớp môi cùng một lúc.
Mọi con số trên trang này đều được đo lường trên các cảnh quay của chính chúng tôi, được tạo bằng Popcraft. Ảnh bìa vẽ biểu đồ các số liệu âm lượng trong bảng đầu tiên. Phương pháp: cao độ qua pYIN trên các khung âm thanh hữu thanh, âm lượng qua máy đo EBU R128, độ khô là tỷ lệ giữa 50 ms đầu tiên của mỗi lần bắt đầu phát âm với 150 ms tiếp theo, độ suy giảm là thời gian để giảm 20 dB sau khi ngừng nói.