簡短版本。 如果你的 AI 主持人聲音在不同片段間發生變化,問題通常不在文字轉語音,而在影片模型。Seedance 2.5 會在每次生成時重新演繹你的配音,並根據景別挑選空間聲學。將響度標準化至單一目標,保持每個說話節拍的拍攝距離一致;當必須保留精確的聲音檔案時,請使用 Wan 3.0 生成,它讓我們的音訊原封不動地通過。
我們針對一位生成主持人教學影片的四個場景測量了五項指標,結果證明文字轉語音是無辜的。
一位女性、一個房間、一種聲音、十二分鐘的素材。每個片段單獨看起來都很棒。但將它們剪輯在一起時,她就變得支離破碎:在一個鏡頭中明亮且貼近,在下一個鏡頭中卻沉悶且遙遠,彷彿她在句子說到一半時,從 Podcast 錄音室晃到了別人的廚房。
為什麼 AI 主持人在每個片段中聽起來都不一樣?
先停止猜測。不斷重新生成直到聽起來正確為止,不僅成本高昂,而且無法告訴你任何資訊。因此,我們針對文字轉語音來源和完成的音訊,在四個場景中測量了相同的五項指標:音高、頻譜亮度、整合響度、底噪和語音電平。一張表格就說明了全部的故事。
| 場景間差異 | 文字轉語音來源 | 完成的片段音訊 |
|---|---|---|
| 響度 | 0.5 LU | 9.4 LU |
| 語音音量 | 2.5 dB | 8.3 dB |
| 音高(中位數 F0) | 17.3 Hz | 9.5 Hz |
| 環境音(底噪) | 10.6 dB | 4.8 dB |
差異 = 從最響的場景到最安靜的場景,從最高音高到最低音高。
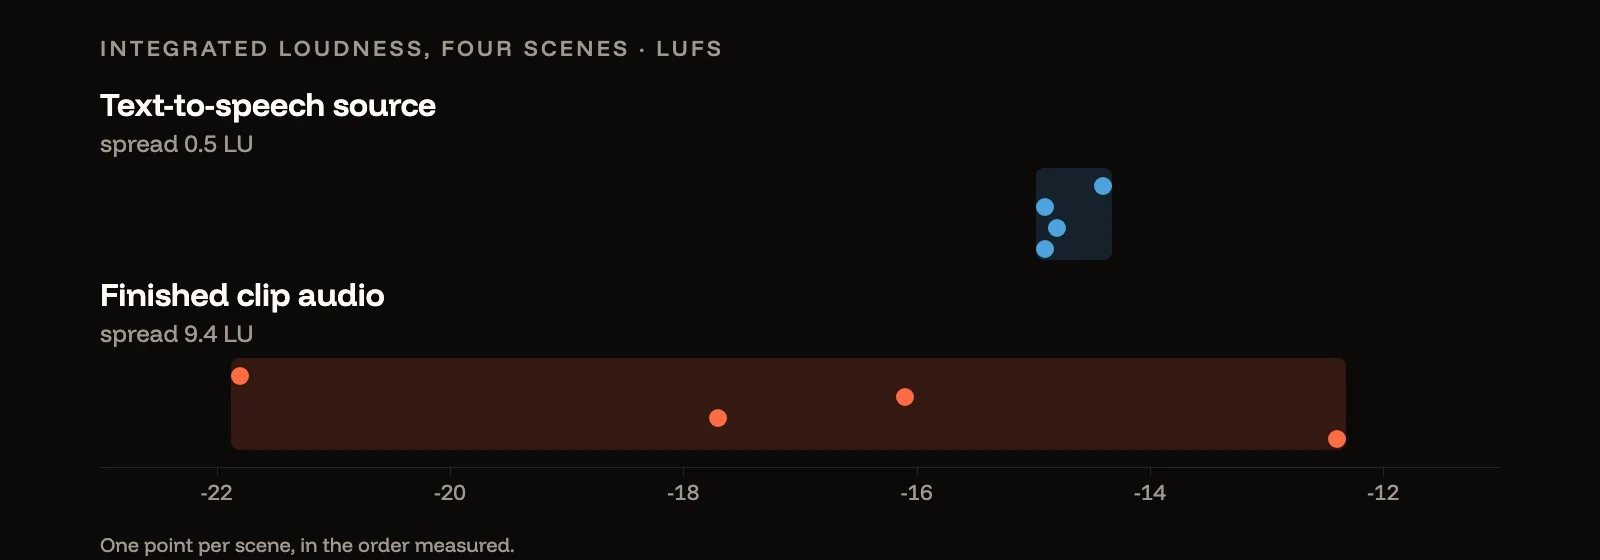
文字轉語音的表現近乎完美:四個場景分別為 −14.4、−14.9、−14.8 和 −14.9 LUFS。影片模型返回的數值則是 −21.8、−16.1、−17.7 和 −12.4。這 9.5 分貝的波動,正是「她每次剪輯聽起來都不一樣」的真實原因。
請注意另外兩行呈現相反趨勢的數據。經過影片模型處理後,音高和環境音反而變得更一致了。我們原本以為會產生漂移的部分,其實根本沒有漂移。
影片模型是使用你的配音,還是重新生成?
有些模型會直接使用,有些則會重新生成。這個發現改變了我們的處理流程。我們將來源音訊與每個完成片段中嵌入的音訊進行互相關分析,然後檢查對齊情況是否成立。
| 模型 | 與來源的相關性 | 片段內的漂移 |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 會歸還你的波形,僅帶有固定的延遲。Seedance 2.5 則會歸還一段全新的演出:以你的參考音訊為條件,明顯是同一個角色,但經過重新合成。與來源相比,它將音高降低了 0.2 到 1.3 個半音,並使音色變暗了 5% 到 19%,且每次錄製的變化都不同。
對於會重新生成的模型,會產生兩個後果,且兩者都很重要。
沒有任何提示詞能解決這個問題。 變異發生在模型的音訊合成內部,而不是任何你能描述的地方。我們曾花時間編寫關於保持一致環境音的仔細指令,後來才意識到環境音本來就是一致的。
你無法把乾淨的音訊換回去。 這看起來像是完美的解決方案——保留良好的畫面,把你純淨的語音軌鋪在下面——但在 Seedance 上這行不通,因為嘴型是跟著模型自己重新計時的演出走的,而該演出到片段結束時,已經與你的檔案漂移了高達 440 ms。
說話的主持人該使用哪個模型?
決定什麼必須在生成過程中保留下來。
- 精確的語音檔案必須保留——克隆的品牌聲音、必須逐字準確的腳本、客戶已經批准的配音。請使用 Wan 3.0。它的輸出會以固定偏移量鎖定在你的檔案上,因此你可以消除延遲並將原始音軌重新鋪回畫面下。每次請求的音訊參考總長上限為 15 秒,因此請以該長度為單位來規劃說話的節奏。
- 演出可以變動——模型自己的演繹是可以接受的,且你更在意畫面而非精確的波形。Seedance 2.5 就很好用,而這篇文章的其餘部分將說明如何讓它的多次錄製保持一致。
無論如何,聲音本身都是從文字轉語音生成器開始的;一致的來源是唯一從來不是問題的部分。
為什麼 AI 主持人在全景鏡頭中聽起來很遙遠?
模型會根據鏡頭來匹配空間感。Podcast 錄音室與廚房的感覺差異來自於空間,因此我們測量了直達聲與殘響聲的比例——聲音聽起來有多乾、多近,相對於周圍有多少空間感——以及每個語句後的衰減時間。
| 場景 | 構圖 | 乾聲程度 | 空間衰減 |
|---|---|---|---|
| 告白節奏 | 特寫 | 2.8 | 116 ms |
| 介紹 | 特寫 | 3.1 | 81 ms |
| 開場 | 全景 | 1.3 | 139 ms |
| 結尾 | 全景 | 0.3 | 209 ms |
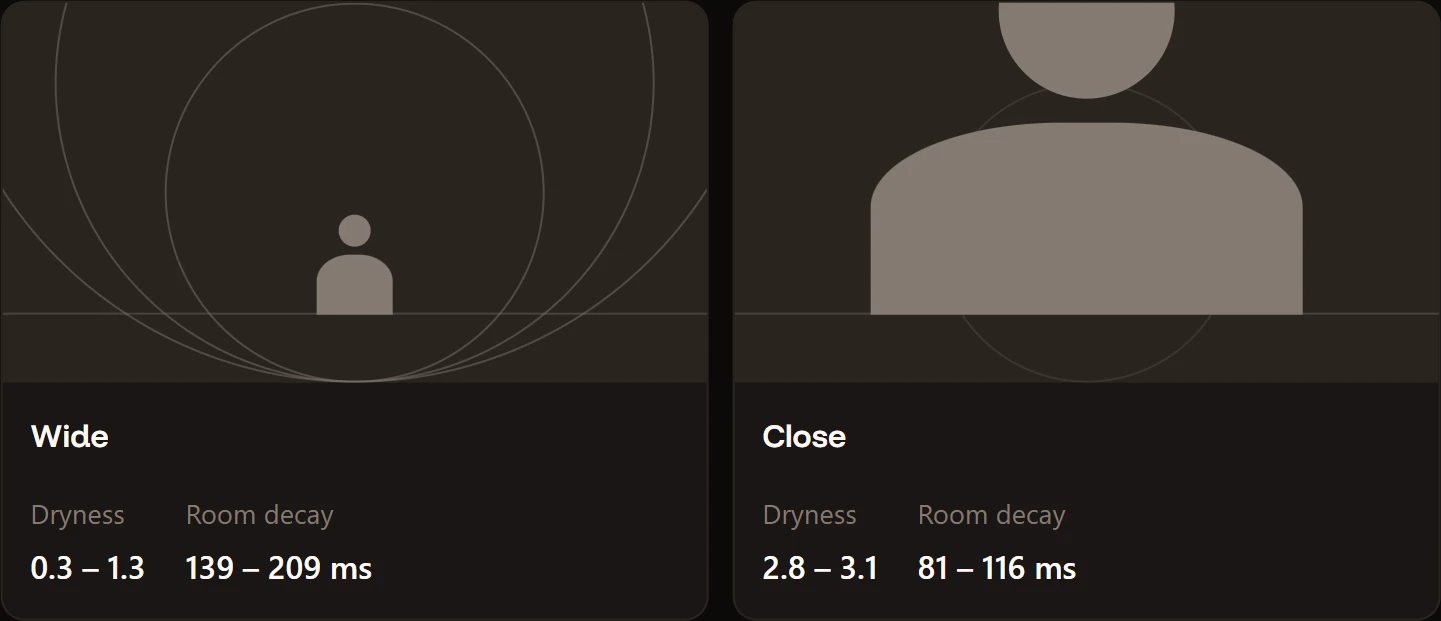
遠景鏡頭是空間感較強的;兩個特寫鏡頭則很乾且親密。模型會從鏡頭大小推斷聲學特性——從房間另一端拍攝的人應該聽起來更遠,所以它就把他們放得更遠。這是很好的電影製作直覺。但這在你把遠景片段與特寫片段剪接在一起,而你的主持人看起來像是瞬間移動之前,是完全隱形的。
可以在後期修復不一致的 AI 影片音訊嗎?
其中三分之二可以。我們建立了一套處理鏈,並確實進行了測量。
| 調整前 | 調整後 | |
|---|---|---|
| 響度差異 | 9.4 LU | 0.4 LU |
| 音色差異 | 2.9 dB | 1.1 dB |
| 空間感差異 | 2.3 dB | 無變化 |
針對單一目標進行兩遍響度標準化,能徹底解決響度問題。這不需要任何成本,而且無論如何你都應該這麼做。測量每個片段,然後根據測量得出的數值進行修正,並為剪輯中的每個片段設定統一的目標值:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
對每個片段施加輕微的擱架式 EQ,就能讓音色大致趨於一致。
殘響是唯一無法妥協的因素。我們為每個片段加入了一個小型的共享空間殘響,讓它們擁有共同的尾音,結果卻讓差異變得更糟,從 2.3 dB 增加到 2.9 dB:共享的殘響會疊加在每個片段原有的尾音上,而不是取代它。匹配殘響只能透過移除來向下處理,而這需要專門的去殘響工具,而非一般的濾波器鏈。
所以,對於「可以在後製中修復嗎」這個問題,誠實的答案是:有三分之二可以免費修復。而剩下的三分之一,避免發生的成本比事後修復更低。
如何讓 AI 主播的聲音在各個片段間保持一致?
靠的是構圖紀律,而不是音訊處理。讓每個說話的鏡頭保持在相同的拍攝距離,空間特性就不會再改變,因為模型不再被要求去改變它。
我們從另一個方向得出了相同的結論。將每個片段輸入影片理解模型作為品質把關,特寫鏡頭在零偏移的情況下,唇形同步得分為 10 分中的 7 分;而廣角鏡頭的得分僅為 4 到 6 分,且帶有 40 到 100 ms 的偏移。它的解釋是:在廣角構圖下,臉部佔比很小,因此嘴型看起來會糊成一團。
兩項獨立的測量,得出一個答案:將生成的主持人拍成特寫,並讓她保持在那裡。 廣角鏡頭應保留給動作、空間,或是任何她沒有說話的場景。如果你需要更穩定的聲學效果,請在提示詞中明確描述,而不是讓模型自行推斷。現在我們的每個提示詞都要求聲音靠近麥克風且無殘響,就像距離領夾麥克風一個手掌寬,且沒有空間殘響一樣。
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
如何自動檢查 AI 的唇形同步?
讓模型為你評分。現代的影片理解模型——任何當前接受影片輸入的多模態模型——都能觀看片段並為唇形同步評分,這將主觀的爭論轉化為一份檢查清單。我們的模型抓到了一個雙唇音始終沒有完全閉合、背景鏡子反射沒有與前景同步動畫,以及模型自行添加了一個未經要求的眨眼。它還估算了以毫秒為單位的音訊偏移量,這正是你在兩條路線中做出選擇所需的確切數值。關於唇形同步模型最初是如何運作的,請參閱 AI 唇形同步技術解析。
一個注意事項:模型選擇的影響比你想像的還要大。一個較舊的模型將每個片段都評為 10 分中的 6 分,並拒絕估算任何偏移量——這對排名毫無用處。一個較新的模型則能清楚地區分它們並給出偏移量。如果你的把關機制顯示所有片段都一樣,請懷疑這個把關機制。
當把關機制在一個原本良好的鏡頭中標記出一個糟糕的細節時,請 編輯該片段而不是重新生成。
簡短總結
- 在重新生成之前先進行測量。各場景間的差異能在一張表中指出是哪個階段出了問題。
- 你的文字轉語音可能沒有問題。
- 有些影片模型會讓你的音訊直接通過;有些則會重新演唱。Seedance 2.5 會重新演唱;Wan 3.0 則讓我們的音訊直接通過。這決定了你是否能將乾淨的音軌替換回去。
- 響度標準化是免費的,且能解決最大的問題。
- 殘響無法透過增加更多殘響來修復。我們測試過了。
- 將說話的鏡頭拍成特寫並保持距離恆定。這能同時修復聲學效果和唇形同步。
本頁面上的所有數值均是基於我們使用 Popcraft 生成的鏡頭所測量得出的。封面繪製了第一個表格中的響度數據。方法:透過 pYIN 計算有聲幀的音高,透過 EBU R128 測量儀計算響度,乾聲程度為每次發聲起始前 50 ms 與隨後 150 ms 的比率,衰減為語音停止後下降 20 dB 所需的時間。