简而言之。 如果你的 AI 主播声音在每个片段间发生变化,问题大概率不在文本转语音,而在视频模型。Seedance 2.5 会在每次生成时重新演绎你的配音,并根据景别选择空间声学环境。将响度标准化到统一目标,保持所有说话镜头的景别距离一致;如果必须保留完全一致的原始声音文件,请使用 Wan 3.0 生成,它在测试中原封不动地保留了我们的音频。
我们对一个包含生成主播的教程中的四个场景测量了五项指标,结果证明文本转语音是无辜的。
一个女人,一个房间,一种声音,十二分钟的素材。每个片段单独看起来都很棒。但把它们剪辑在一起时,她的声音就崩了:在一个镜头中明亮且贴近,在下一个镜头中却沉闷且遥远,就好像她在句子说到一半时,从播客录音棚闲逛到了别人的厨房。
为什么 AI 主播在每个片段中听起来都不一样?
首先,停止盲目猜测。不断重新生成直到听起来合适不仅成本高昂,而且无法告诉你任何实质信息。因此,我们在四个场景中对文本转语音源音频和最终成品音频测量了相同的五项指标:音高、频谱亮度、综合响度、本底噪声和语音电平。一张表格就说明了全部问题。
| 场景间差异 | 文本转语音源 | 最终片段音频 |
|---|---|---|
| 响度 | 0.5 LU | 9.4 LU |
| 语音电平 | 2.5 dB | 8.3 dB |
| 音高(中值 F0) | 17.3 Hz | 9.5 Hz |
| 环境音(本底噪声) | 10.6 dB | 4.8 dB |
差异 = 最响场景到最安静场景,最高音高到最低音高。
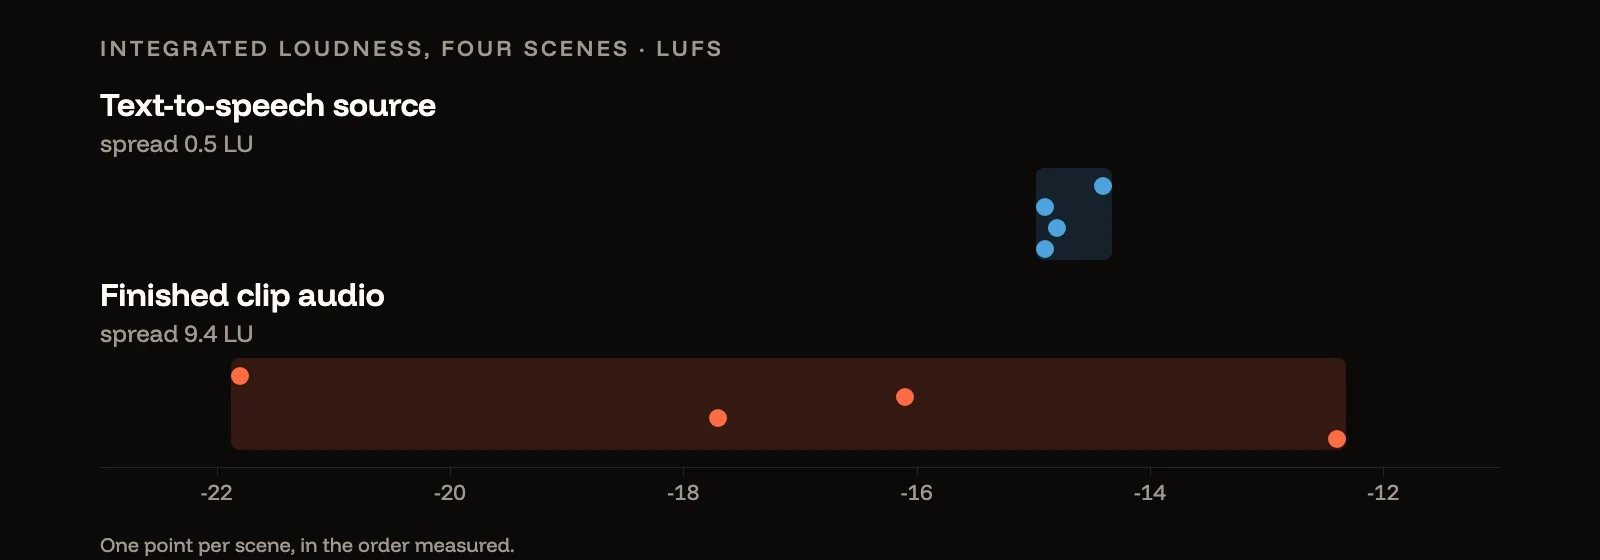
文本转语音的效果近乎完美:四个场景分别为 −14.4、−14.9、−14.8 和 −14.9 LUFS。而视频模型返回的结果是 −21.8、−16.1、−17.7 和 −12.4。这 9.5 分贝的波动,正是“她每次剪辑听起来都不一样”的真正原因。
注意另外两行呈现的相反趋势。经过视频模型处理后,音高和环境音反而变得更加一致了。我们原以为会发生漂移的部分,实际上根本没有漂移。
视频模型是使用你的配音,还是重新生成配音?
有些模型会直接使用。有些则会重新合成。这一发现改变了我们的工作流。我们将源音频与每个最终片段中嵌入的音频进行了互相关分析,然后检查这种对齐是否成立。
| 模型 | 与源音频的相关性 | 片段内的漂移 |
|---|---|---|
| Seedance 2.5 | 0.30 – 0.55 | 120 – 440 ms |
| Wan 3.0 | 0.82 – 0.95 | 0 ms |
Wan 3.0 会返回你的波形,仅带有固定的延迟。Seedance 2.5 则会返回一段全新的演绎:它以你的参考音频为条件,角色辨识度依然相同,但经过了重新合成。与源音频相比,它将音高降低了 0.2 到 1.3 个半音,并使音色变暗了 5% 到 19%,且每次生成的结果都不尽相同。
对于重新合成音频的模型,会产生两个重要后果。
没有任何提示词能修复这个问题。 这种差异发生在模型的音频合成内部,而不是你可以通过描述来解决的。我们曾花大量时间编写关于保持环境音一致的详细指令,后来才意识到环境音本身已经是一致的了。
你无法把干净的音频重新替换回去。 这看起来是个完美的解决方案——保留优质的画面,在底层铺上你纯净的原始音轨——但在 Seedance 上行不通,因为口型跟随的是模型自己重新调整时间后的演绎,到片段结尾时,它已经与你的文件产生了高达 440 ms 的漂移。
制作数字人播报视频应该使用哪个模型?
明确在生成过程中必须保留什么。
- 必须保留完全一致的音频文件——克隆的品牌声音、必须逐字精准匹配的脚本,或客户已经批准的配音。请使用 Wan 3.0。它的输出与你的文件保持固定偏移量锁定,因此你可以消除延迟,并将原始音轨重新铺回画面下方。每次请求的音频参考总时长上限为 15 秒,因此请按此时长规划说话片段。
- 演绎方式可以改变——模型自己的朗读效果可以接受,且你更看重画面而非精确的波形。Seedance 2.5 就可以胜任,本文的其余部分将介绍如何保持其多次生成结果的一致性。
无论哪种方式,声音本身都始于文本转语音生成器;一致的源音频是从来不曾出问题的环节。
为什么 AI 主播在远景镜头中听起来很远?
模型会根据镜头匹配房间声学。播客录音棚与厨房的听感差异来自于房间环境,因此我们测量了直达声与混响声的比例——即声音听起来有多干、多近,与周围空间感的对比——以及每个乐句后的衰减时间。
| 场景 | 景别 | 干声度 | 房间衰减 |
|---|---|---|---|
| 倾诉节拍 | 特写 | 2.8 | 116 ms |
| 介绍 | 特写 | 3.1 | 81 ms |
| 开场 | 远景 | 1.3 | 139 ms |
| 结尾 | 远景 | 0.3 | 209 ms |
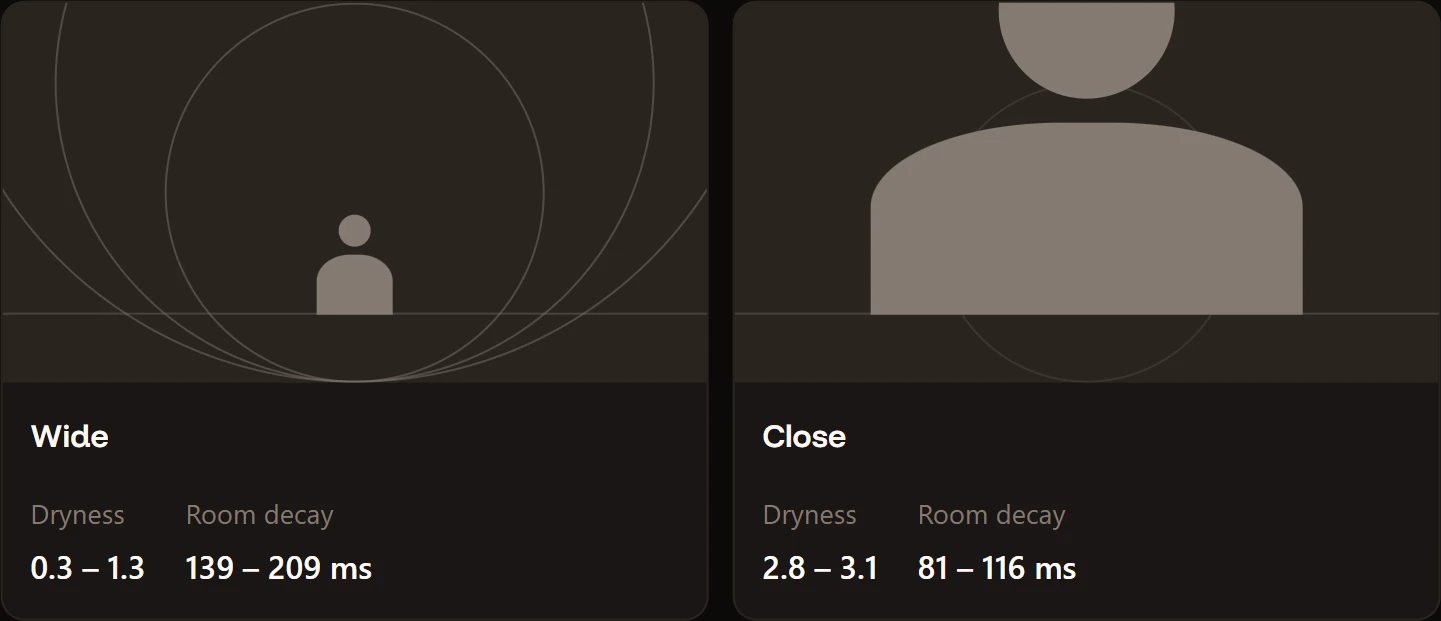
远景镜头的空间感更强;两个特写镜头的声音则很干且亲密。模型会根据景别推断声学特征——从房间对面拍摄的人理应听起来更远,所以它就把声音推远了。这是很好的电影制作直觉。但当你把一个远景节拍与一个特写节拍剪辑在一起时,这种处理就会暴露无遗,让你的主播听起来像是瞬间移动了。
你能在后期修复不一致的AI视频音频吗?
能修复三分之二。我们搭建了一条匹配链路,并进行了如实测量。
| 处理前 | 处理后 | |
|---|---|---|
| 响度差异 | 9.4 LU | 0.4 LU |
| 音色差异 | 2.9 dB | 1.1 dB |
| 空间混响差异 | 2.3 dB | 无变化 |
针对单一目标进行双遍响度标准化,可以彻底解决响度问题。这不需要任何成本,无论如何你都应该这么做。测量每个片段,然后使用测量返回的数值对其进行校正,对剪辑中的每个片段使用同一个目标值:
# pass 1: measure. Read the five measured_* values out of the JSON it prints.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:print_format=json -f null -

# pass 2: correct, pasting pass 1's own numbers into the placeholders.
ffmpeg -i clip.mp4 -af loudnorm=I=-14:TP=-1.5:LRA=11:measured_I=<input_i>:measured_TP=<input_tp>:measured_LRA=<input_lra>:measured_thresh=<input_thresh>:offset=<target_offset>:linear=true -c:v copy out.mp4
对每个片段进行温和的搁架式EQ调节,就能让音色基本保持一致。
混响是唯一无法妥协的因素。我们为每个片段添加了一个小型的共享空间混响,让它们共享同一个尾音,结果却让差异变得更糟了,从 2.3 dB 增加到了 2.9 dB:共享混响会叠加在每个片段现有的尾音上,而不是替换它。匹配混响只能通过做减法来移除它,而这需要专门的去混响工具,而不是滤波链。
因此,对于“我能在后期修复它吗”这个问题,诚实的回答是:其中三分之二可以免费修复。剩下的三分之一,避免产生的成本比后期修复更低。
如何让AI主持人的声音在不同片段间保持一致?
靠构图纪律,而不是音频。让每个说话节拍保持相同的景别距离,房间声学特征就不会再发生变化,因为模型不再被要求去改变它。
我们从另一个方向得出了相同的结论。将每个片段通过视频理解模型作为质量把关,特写镜头的口型同步得分为 10 分中的 7 分,偏移量为零;全景镜头的得分为 4 到 6 分,偏移量为 40 到 100 ms。它的解释是:在全景构图中,人脸很小,所以嘴型看起来模糊不清。
两项独立的测量,一个答案:近距离拍摄你生成的虚拟主持人,并让她保持在这个距离。 将全景镜头用于动作、展示房间,或任何她没有说话的场景。如果你需要声学环境更加稳定,请在提示词中明确描述它,而不是让模型去推断。现在的每个提示词都要求声音靠近麦克风且干声,就像在距离一掌宽的领夹麦克风前一样,没有房间回声。
close and dry to the microphone, as if on a lapel mic a hand's width away, with no room echo
如何自动检查AI口型同步?
让模型为你打分。现代视频理解模型——任何当前接受视频输入的多模态模型——都会观看片段并对口型同步进行评分,这将主观争论变成了一个检查清单。我们的模型捕捉到了一个从未完全闭合的双唇辅音、一个没有随前景一起动画的背景镜子反射,以及模型自行添加的一个未经请求的眨眼动作。它还以毫秒为单位估算了音频偏移量,这正是你在两条路线之间做出选择所需的数值。有关口型同步模型最初是如何工作的,请参阅 AI口型同步技术解析。
一个注意事项:模型的选择比你想象的更重要。一个较旧的模型对每个片段的评分都完全相同,都是 10 分中的 6 分,并且拒绝估算任何偏移量——对排名毫无用处。一个较新的模型则清晰地将它们区分开来,并给出了偏移量。如果你的质量把关显示所有片段都一样,那就怀疑这个把关机制吧。
当质量把关在一个原本很好的镜头中标记出一个糟糕的细节时,编辑该片段而不是重新生成。
简短总结
- 在重新生成之前先进行测量。跨场景的差异能在一张表中指出是哪个环节出了问题。
- 你的文本转语音可能没有问题。
- 有些视频模型会直接透传你的音频;有些则会重新合成。Seedance 2.5 会重新合成;Wan 3.0 则透传了我们的音频。这决定了你是否能把干净的音轨换回去。
- 响度标准化是免费的,并且能解决最大的问题。
- 混响无法通过添加更多混响来修复。我们验证过了。
- 近距离拍摄说话镜头并保持距离恒定。这能同时修复声学环境和口型同步。
本页面上的所有数据均基于我们使用 Popcraft 生成的镜头测量得出。封面绘制了第一张表格中的响度数据。方法:通过 pYIN 算法在浊音帧上提取音高,使用 EBU R128 响度计测量响度,干声程度定义为每次发音起始后的前 50 ms 与随后 150 ms 的能量比,衰减定义为语音停止后下降 20 dB 所需的时间。