NEW从文字或图片生成 3D 模型 — 支持绑定、动画制作与导出。立即体验 3D
PopcraftPopcraft
ElevenLabs 语音模型

Eleven v4 + Eleven v4 Turbo它不是在朗读脚本。
它是在生动演绎。

ElevenLabs 称 Eleven v4 是“我们迄今最具情感表现力的文本转语音模型”。通过内联标签将语气写入脚本,支持 90 多种语言,单次生成高达 10,000 字符。而 v4 Turbo 的响应速度足以支撑实时对话。

[whispers] Don't move. It's right behind you.Eleven v4语音合成生成
90+ 语言10,000 单次生成字符数内联 音频标签
一位女配音演员在昏暗的录音棚里对着电容麦克风录音,一盏温暖的实用灯照亮了画面
角色配音
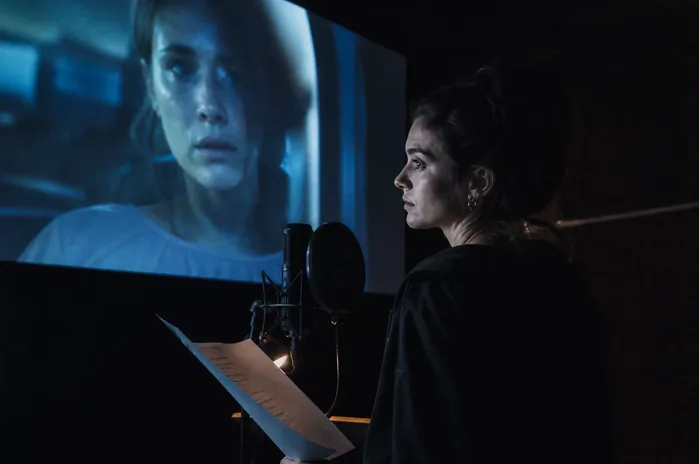
配音棚:一位女演员注视着投影画面,屏幕的光照亮了她的脸庞
译制配音
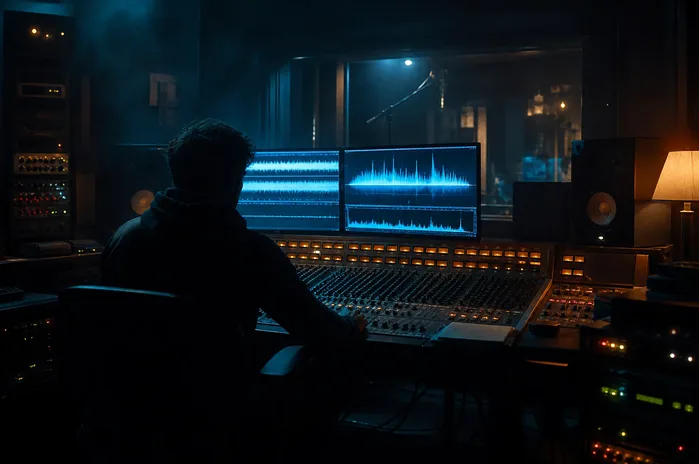
夜间的控制室,工程师面前的显示器上闪烁着波形图
演绎指令
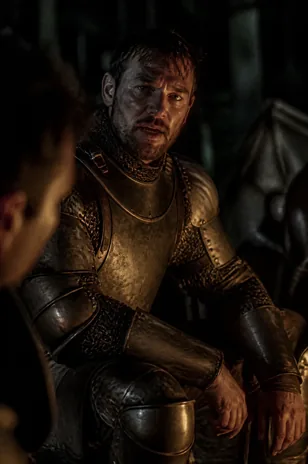
游戏角色:火光下的重甲骑士,正在念台词
游戏 NPC
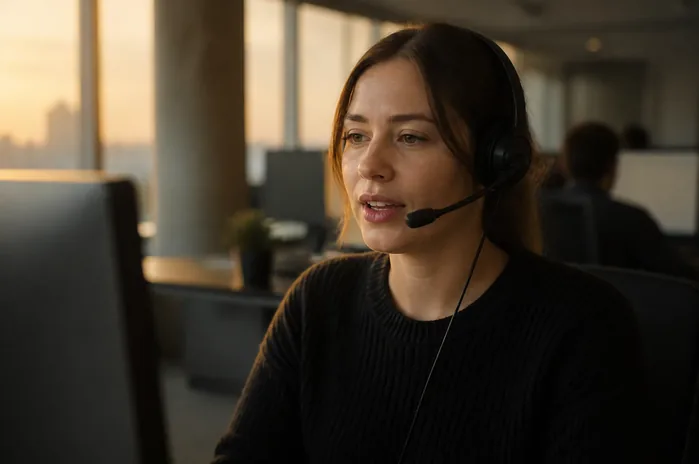
清晨的办公室,一位客服戴着耳机正在通话
语音智能体
一位银发旁白坐在扶手椅中,在阅读灯下朗读着一本精装书
有声书

听听看。每段音频旁都附有脚本。

8 次生成,均在 Popcraft 中完成。橙色括号内的文字就是全部的演绎指令:没有经过任何剪辑,没有拼接多次重录的片段,音频中也没有任何脚本之外的内容。

01

一句话,五种演绎

[warm] The lighthouse keeper left a lamp burning for ships that never came.

[low, threatening] The lighthouse keeper left a lamp burning for ships that never came.

[rushed] The lighthouse keeper left a lamp burning for ships that never came.

[a tired detective who has heard it all before] The lighthouse keeper left a lamp burning for ships that never came.

[hushed and reverent, like a nature documentary narrator] The lighthouse keeper left a lamp burning for ships that never came.

02

游戏 NPC,情绪反转的一句台词

[casual] You're looking for work, eh? Hmm, I might have something for you. [door creaking] [suddenly suspicious, lowering his voice] Wait. Who sent you? [pause] [delighted] Marta's cousin! Well why didn't you say so. [coins clinking] Half now, half when it's done.

03

同一个节奏,四种语言

[softly] Don't be afraid. We'll cross together when the morning comes.

[softly] 怖がらないで。朝が来たら、一緒に渡ろう。日语

[softly] Não tenha medo. Vamos atravessar juntos quando a manhã chegar.巴西葡萄牙语

[softly] 别害怕。等天亮了,我们一起过去。普通话

相同的声音,相同的标签,这是 ElevenLabs 表示在 v4 中提升最大的四种语言。

04

听起来像真人的客服智能体

[warm] Thanks so much for holding. I can see the duplicate charge right here. [reassuring] You don't need to do anything else; the refund goes out today. [clear, measured] And your eSIM for Reykjavik is active. Anything else I can check?

v4 Turbo 专为在实时通话中稳定保持这种语气而打造。

05

始终如一的耳语

[whispers] Don't move. It's right behind you. [pause] [whispers] On three, we run. One. Two. [shouts] Run!

06

有声书冷开场

[quiet, measured narration] When I was young, I thought the mountain stood because it was strong. [pause] I know better now. [long pause] It stood because it had learned where to bend.

v4 单次请求支持 10,000 个字符,约十分钟音频。

07

周一早晨

[sleepy drowsy voice] Mmm, five more minutes. [yawning] Is it really Monday already?

08

用通俗语言指导

[like a sports commentator, speeding up] She takes it on the half-volley, past one, past two, she's through on goal. [amazed] Oh, that is extraordinary!

标签不必从列表中选择。只需描述演绎方式,模型即可完美呈现。

两款模型。一款用于演绎,一款用于对话。

以前,你必须在富有表现力的语音和响应快的语音之间做取舍。Eleven v4 终结了这一妥协:标准模型胜任长篇任务,Turbo 则负责实时通话。

专为创作者打造

Eleven v4

专为内容创作和长篇音频打造:有声书、角色配音、长篇旁白。你写下的演绎方式就是最终呈现的效果,包括场景音效。

  • 10,000每次请求字符数,单次生成约十分钟音频
  • 90+种语言,较 v3 的 70 多种大幅增加
  • 标签情感、节奏、反应、口音和音效,均可内联编写
  • IPA精确发音,写在正斜杠之间
“我们在表现力语音生成领域最新研究的集大成者。”ElevenLabs,发布博文
适用于语音智能体

Eleven v4 Turbo

表现力依旧,专为实时场景调优:根据 ElevenLabs 的测量,推理延迟中位数约 100 毫秒,首字发声时间约 150 毫秒。

  • 约 100 毫秒推理延迟中位数
  • 约 150 毫秒首字发声时间中位数
  • 实时支持在对话过程中自适应调整语气的客服、销售和预约通话
“比两人交谈时的平均停顿时间还要快。”ElevenLabs,发布博文

像在录音棚里指导配音演员一样掌控

所有控制均直接写在脚本中。无需滑块,无需后期。

音频标签

在情感发生处直接标注

标签以方括号形式内联在文本中,并从其所在位置生效直至下一个标签。共六种类型:情感、演绎、节奏、反应、口音和音效。使用逗号堆叠提示,模型将按顺序依次演绎。

[excited] Big news, everyone. [pause] [whispers] The summer menu drops Friday. [laughs]
逆光光晕中电容麦克风的特写
语言

90 多种语言,同一种声音

ElevenLabs 认为跨语言的富有表现力的语音是音频 AI 领域最棘手的难题之一。v4 覆盖 90 多种语言,其中日语、巴西葡萄牙语、普通话和粤语的提升最为显著。同一种声音在所有语言中都能保持相同的演绎风格,让配音作品完美保留原有选角。

四名广播剧演员围聚在同一个麦克风前
长篇音频

单次请求 10,000 个字符

容量是 v3 的两倍:单次生成约 10 分钟的音频。无论是整个章节、完整的客服脚本还是长篇场景,都能作为一段连贯的录音保持节奏,无需再拼接零散的段落。

温暖的灯光下,录音室麦克风旁放着一叠高高的剧本手稿
发音

使用 IPA 实现精准发音

人名、药名、地名、产品名:只需用斜杠包裹 IPA 音标,模型每次都能按你的方式准确发音。而在其他所有发音测试中,v4 均拿下了 Artificial Analysis 评测史上的最高发音得分。

The ferry to Reykjavik /ˈreɪkjavɪk/ leaves at nine.
乐谱架上放着一页用铅笔做好标记的剧本
声音克隆

专业声音克隆重磅回归

v3 从未支持过专业声音克隆,而 v4 现已全面支持,让你拥有的定制声音能够运用完整的标签词汇库进行演绎。在早期模型上创建的克隆只需一键即可针对 v4 重新训练,且每次克隆均经过声音所有者的验证授权。

录音室机架上并排摆放着两台一模一样的开盘磁带录音机

背后的故事

ElevenLabs 的每一次迭代都在突破某一项极限。而 v4 是首个让你无需再为此妥协取舍的版本。

  • 2023 年 8 月

    Multilingual v2

    29 种语言,ElevenLabs 结束测试。

  • 2024 年 7 月

    Turbo v2.5

    为速度而生。

  • 2024 年 12 月

    Flash

    延迟降至约 75 毫秒。速度很快,但表现力不足。

  • 2025 年 6 月

    Eleven v3 alpha

    音频标签、70 多种语言和对话功能上线。表现力丰富,但 v3 自己的发布帖却建议实时应用开发者继续使用 Flash。

  • 2026 年 2 月

    Eleven v3 正式发布

    表现力日臻成熟。速度上的取舍依然存在。

  • 2026 年 6 月

    华沙预览版

    在华沙峰会上,ElevenLabs 现场演示了下一代模型的低语、口音切换和实时情感变换。

  • 2026 年 9 月 28 日

    Eleven v4 + v4 Turbo

    全新架构同时向两个方向发力:ElevenLabs 打造的表现力最强的模型,以及速度快到足以支持实时对话的 Turbo。

实力证明

独立评测优先:Artificial Analysis 针对各大主流语音模型开展盲听竞技场测试。

Artificial Analysis,2026 年 10 月Eleven v4背景
Provider Voice 竞技场第 1 名领先于 Cartesia Sonic 3.6 和 Gemini 3.8 Flash TTS。Eleven v3 在同一榜单中位列第 17 名。
发音鲁棒性91.7%Artificial Analysis 在所有模型中测得的最高分。
Controlled Voice 竞技场第 2 名仅次于 Qwen-Audio-3.1-TTS-Plus。v3 的得分远低于这两者。
生成速度73.4 字符/秒v3 为 42.5,由 Artificial Analysis 测得。

在 ElevenLabs 自己的盲听偏好测试中,听众在约 75% 的情况下选择了 v4 而非竞品模型。该数据来自厂商;上方的竞技场排名则不然。发布当天的反响:公告帖子与 Artificial Analysis 结果。

v3 以来的变化

Eleven v3Eleven v4
架构v3 系列全新
语言70+90+
请求长度5,000 个字符10,000 个字符
专业声音克隆不支持支持
演绎指令音频标签标签、自然语言指令、IPA
实时不推荐v4 Turbo,中位推理约 100 毫秒

你为 v3 编写的脚本无需修改即可在 v4 上运行。

常见问题

我现有的克隆声音能在 v4 上使用吗?

重新训练后可以。在早期模型上制作的克隆声音,只需在 ElevenLabs 的声音库中一键即可为 v4 重新训练。但请做好心理准备:重新训练后的声音听起来可能与 v3 版本大不相同,源录音中的瑕疵会被如实还原,而且使用 Voice Design 构建的声音在表现力上可能不如录音克隆。

音频标签总是能准确生效吗?

并非总是如此。ElevenLabs 官方文档也承认标签跟随“尚不完美”:偶尔提示指令会被渲染成音效。要想获得最可靠的结果,建议每个从句只使用一个标签,并将其放在受影响的词语之前;如果需要叠加多个提示,请用逗号将它们连接在同一个方括号内。

当声音说出非母语语言时会发生什么?

它会带有该语言的原生口音,而不是声音本身的母语口音。ElevenLabs 表示这是有意为之,并且正在研究保留原口音的切换选项。

v4 有哪些控制选项?

稳定性和相似度。没有风格或语速滑块,也不支持 SSML;停顿需在脚本中写为 [pause] 和 [long pause],其余控制均通过标签实现。

选 v4 还是 v4 Turbo?

v4 适用于所有需要渲染并保存的内容:旁白、角色演绎、长达 10,000 字符的配音级朗读。v4 Turbo 适用于所有需要实时对话的场景:语音智能体和交互式应用,其约 100 毫秒的中位推理延迟可确保对话流畅进行。

创作极致演绎,v4 完美呈现。

挑选音色,在括号内添加演绎指导,数秒内即可试听效果。

本页所有音频均在 Popcraft 中使用 ElevenLabs 音色生成;每段音频的完整脚本显示在其旁边。图像由 AI 生成。引用文案出自 ElevenLabs 官方的Eleven v4 发布博文。排名数据来自 Artificial Analysis,读取于 2026 年 10 月。

继续探索

相关模型